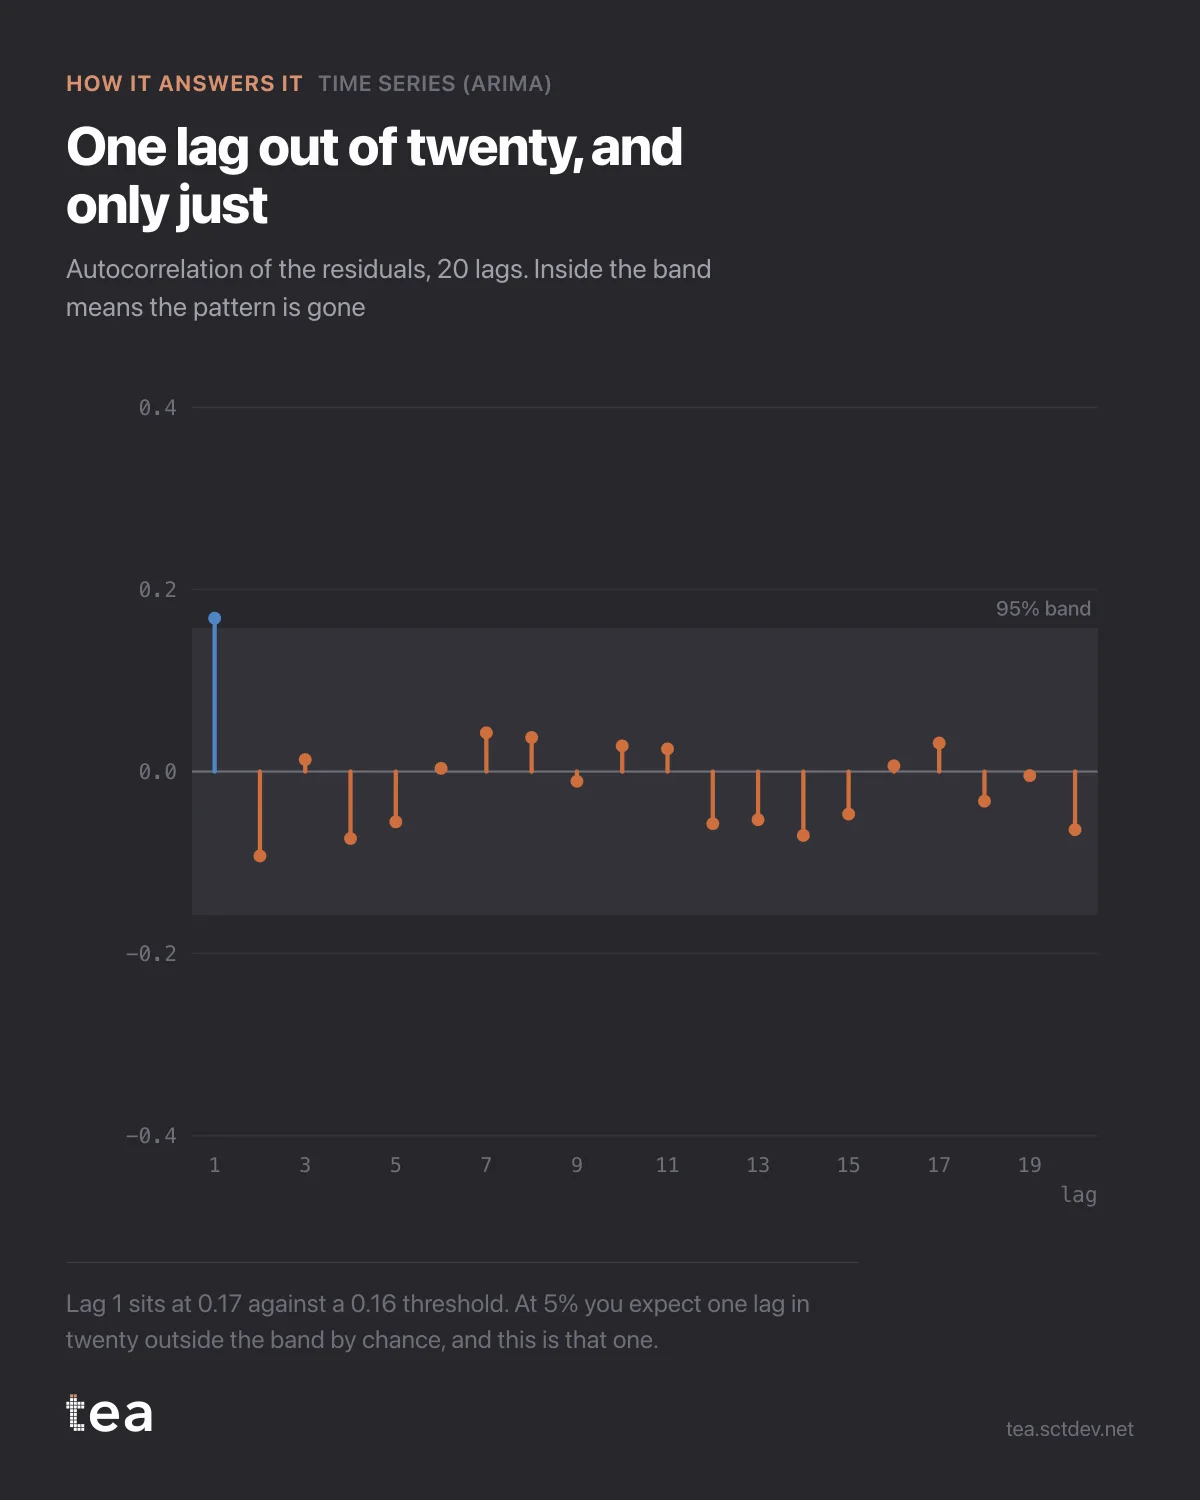
Este es el gráfico que te dice si una previsión está terminada, y casi nadie lo mira.
Es la autocorrelación de los residuos: lo que el modelo no logró explicar, examinado para ver si todavía tiene forma. Veinte retardos y una banda que marca dónde estaría el ruido aleatorio.
La lógica es sencilla. Si lo que sobra todavía tiene un patrón, el modelo no ha terminado de comer. Un pico en el retardo 52 con datos semanales significa que se ha quedado sin capturar una estacionalidad anual. Un decaimiento lento en los primeros retardos significa que el término de impulso es demasiado débil. En ambos casos hay señal en el suelo, y su sitio es la previsión, no el error.
Aquí, un retardo de veinte asoma por encima de la línea. El retardo 1 está en 0,17 frente a un umbral de 0,16.
Ahora viene la parte que merece decirse en voz alta, porque es donde los informes suelen faltar a la verdad en ambas direcciones.
Con una banda del 95 % esperas que uno de cada veinte retardos quede fuera por azar. Eso es lo que significa la banda. Un único rebase marginal en el primer retardo no es evidencia de un problema, y tampoco es algo que haya que esconder. Es el coste esperado de poner a prueba veinte cosas a la vez.
Lo que cambiaría el veredicto es un patrón: varios retardos fuera, o uno solo grande en una posición estacional, o el mismo retardo fuera en especificaciones distintas. Aquí no hay nada de eso.
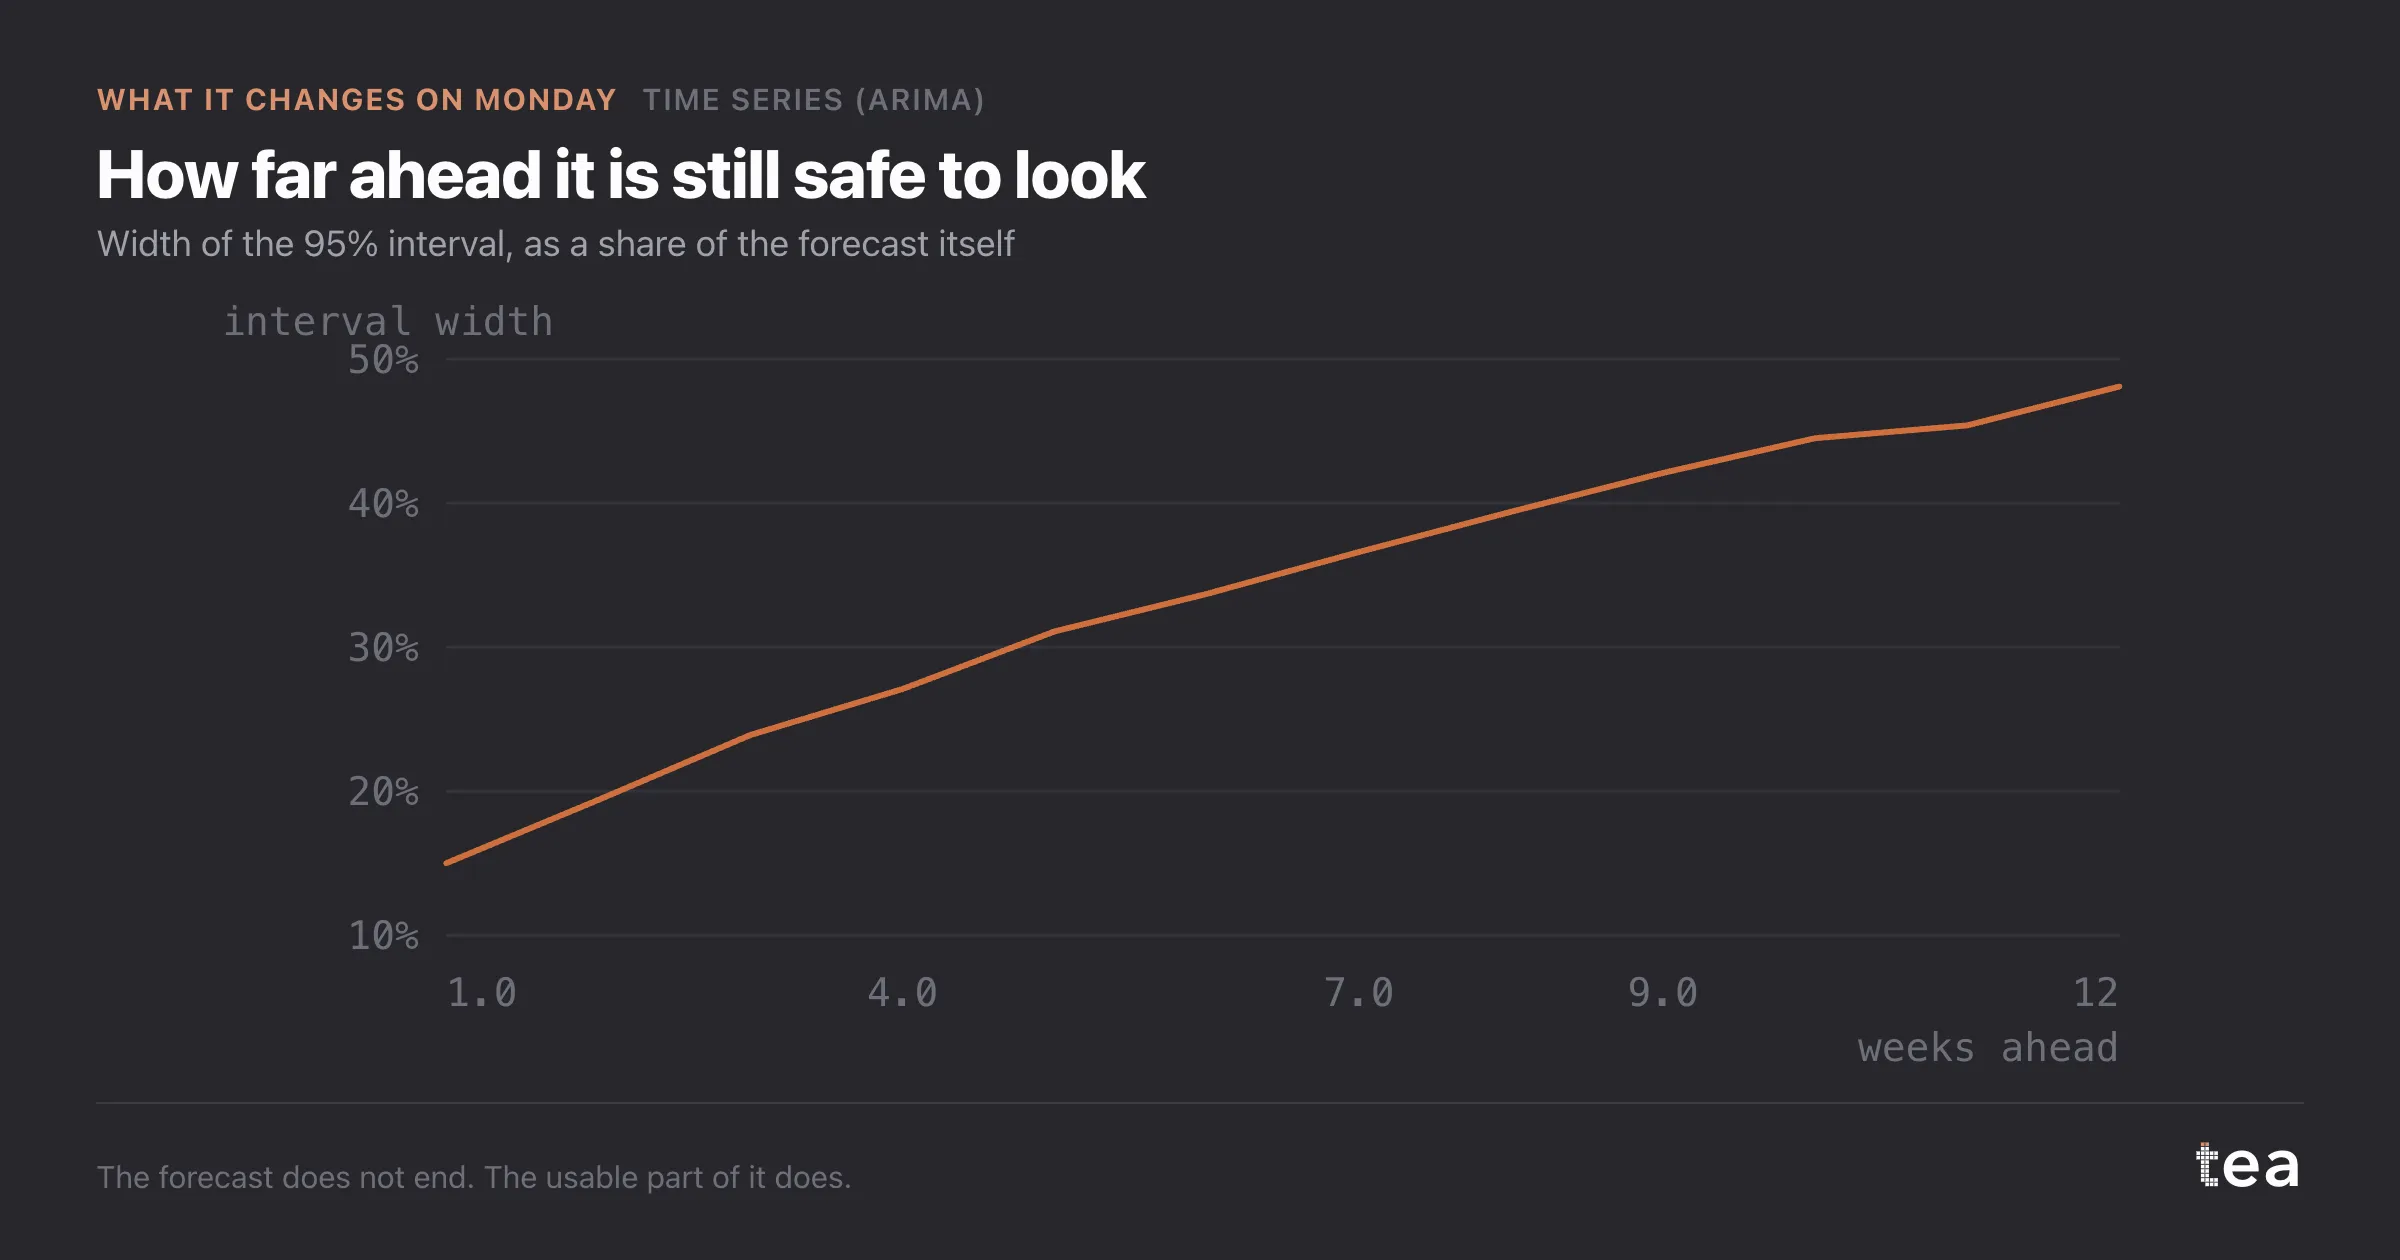
Así que los residuos se parecen lo bastante al ruido como para fiarse del intervalo, y ese es todo el sentido de hacer esta prueba. La banda de confianza de la previsión se calcula como si los residuos se comportaran bien. Si no lo hacen, la banda es demasiado estrecha, y una banda demasiado estrecha es peor que ninguna, porque invita a tomar una decisión que los datos no pueden sostener.
Esta es la parte de la previsión que no cabe en un titular. Un número es fácil. Un número que puedas defender requiere cuatro gráficos más, y este es uno de ellos.
TEA ejecuta los diagnósticos de residuos junto con el ajuste y los muestra al lado de la previsión, sin que haya que pedirlos, porque una previsión sin ellos es una opinión con decimales.
Si te quedas con un solo hábito de este post, que sea este. Cuando alguien te entregue una previsión, pregunta cómo son los residuos. Si la respuesta es un encogimiento de hombros, el intervalo de esa previsión es decoración, y el intervalo es justo la parte con la que ibas a tomar una decisión.
Además, es la comprobación más barata de todo el proceso. El ajuste ya está calculado, los residuos ya existen y la prueba son veinte números frente a una línea. Si se salta, no es por el coste: es porque nadie la pide.
El gráfico es el resultado real de Series temporales (ARIMA) en TEA.
tea, el producto
Tu archivo, esta pregunta
Quince análisis sobre un CSV de datos semanales, con los intervalos y los diagnósticos a la vista, y una frase clara cuando los datos no pueden responder. Gratis durante la beta, por invitación.
Pide una plaza en la beta→tea, el producto
Quince análisis econométricos con tu propio CSV: Series temporales (ARIMA), curvas de saturación, elasticidades, asignación del presupuesto. Intervalos y diagnósticos a la vista, y una frase clara cuando el archivo no puede responder.
Gratis durante la beta, por invitación.
Pide una plaza en la beta →¿Te ha servido? Ejecútalo con tus propios datos.
tea ejecuta Series temporales (ARIMA) y otros catorce análisis con cualquier CSV semanal, en minutos. Gratis durante la beta, por invitación.