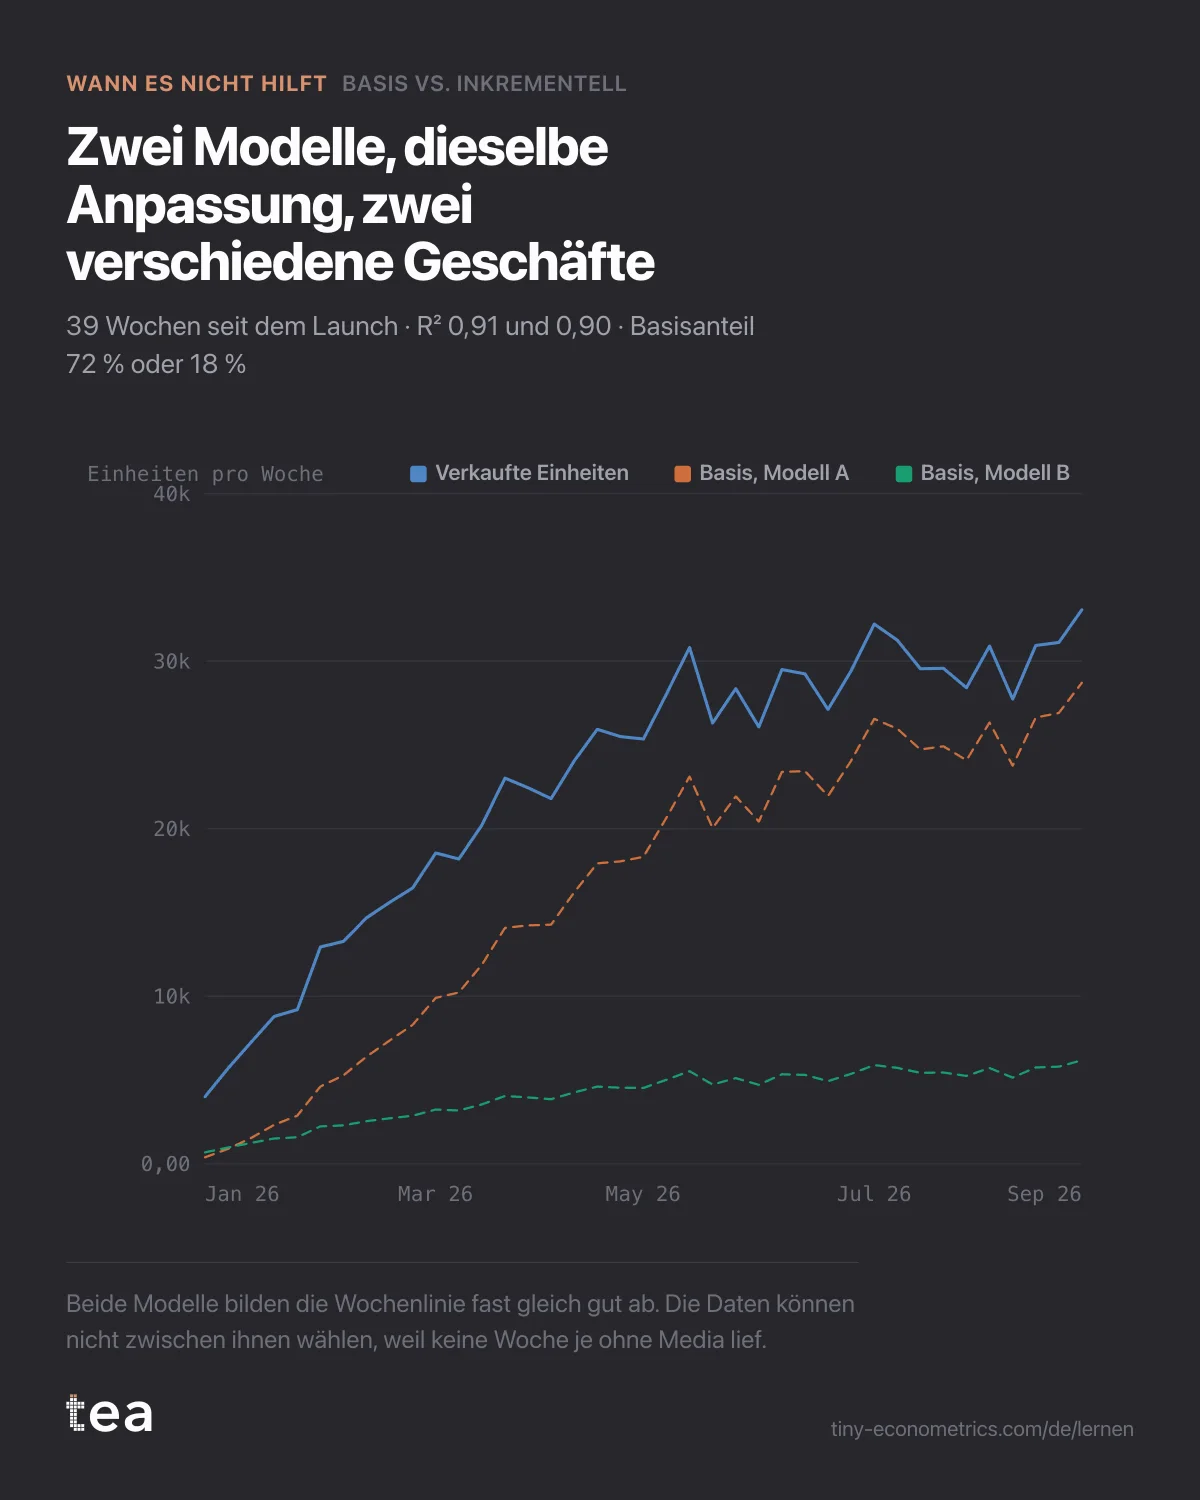
Deutscher pflanzlicher Proteindrink, 39 Wochen seit dem Launch, Media in jeder Woche, der Vorstand fragte, wie viel ohne Werbung verkauft würde.
Ein zusammengesetzter Fall, gebaut aus der Art von Datei, die wir fast jede Woche sehen. Ein pflanzlicher Proteindrink, am 5. Januar 2026 in Deutschland gelauncht, verkauft über Lebensmittelhandel und Drogeriemärkte, mit einem Launch-Budget, das ab der ersten Woche lief.
Nach neun Monaten stellte der Vorstand die Frage, mit der die Story Entdeckung endet: „Wie viel von dem, was wir verkaufen, würden wir ohne Werbung verkaufen? Wir müssen wissen, worauf die Marke steht, bevor wir das Budget für nächstes Jahr festlegen.“
Es ist eine gute Frage. Diese Datei kann sie nicht beantworten.
Wie die Datei aussah
39 Wochenzeilen, Januar bis September 2026. Verkaufte Einheiten, steigend von etwa 4.000 in der ersten Woche auf etwa 33.000 in der letzten, 892.000 insgesamt. Mediaausgaben über TV, Social und Retail Media, zwischen 40.000 € und 70.000 €, in jeder einzelnen Woche. Filialzahl, von etwa 1.200 im Januar auf 4.800 bis zum Sommer, als die Listungen durchkamen. Durchschnittspreis, nahezu konstant.
Was fehlte, ist genau das, worum es in der Frage geht. Es gibt keine Woche ohne Media. Es gibt keine Woche mit wenig Media. Die niedrigsten Ausgaben in der Datei liegen bei 40.000 €.
Warum sich die Aufteilung nicht machen lässt
Basis vs. Inkrementell baut die Basis, indem es Media in einem geschätzten Modell auf null setzt und abliest, was übrig bleibt. Im Händlerfall funktionierte das, weil die Datei Funkstillen und Wochen nahe null hatte. Die Null des Modells lag nahe an etwas, das es gesehen hatte.
Hier liegt die Null des Modells 40.000 € von der nächsten Beobachtung entfernt. Was immer es über eine Welt ohne Media sagt, ist eine reine Extrapolation aus einer Spanne von 40.000 € bis 70.000 €, ohne jeden Anker.
Es ist schlimmer als nur Abstand. Drei Dinge wuchsen über dieselben 39 Wochen gemeinsam: die Zahl der Filialen, die Bekanntheit, die jede neue Marke aufbaut, wenn Menschen ihr begegnen, und das kumulierte Mediagewicht, das der Adstock vorwärts trägt. Jedes davon kann eine steigende Absatzlinie erklären. Das ist dasselbe Problem wie im Fall mit TV und Suche, mit einer zusätzlichen Wendung: Einer der kollinearen Treiber ist die Zeit selbst.
Also schätzten wir drei vertretbare Modelle, als Test dafür, wie stark die Antwort von der Wahl abhängt:
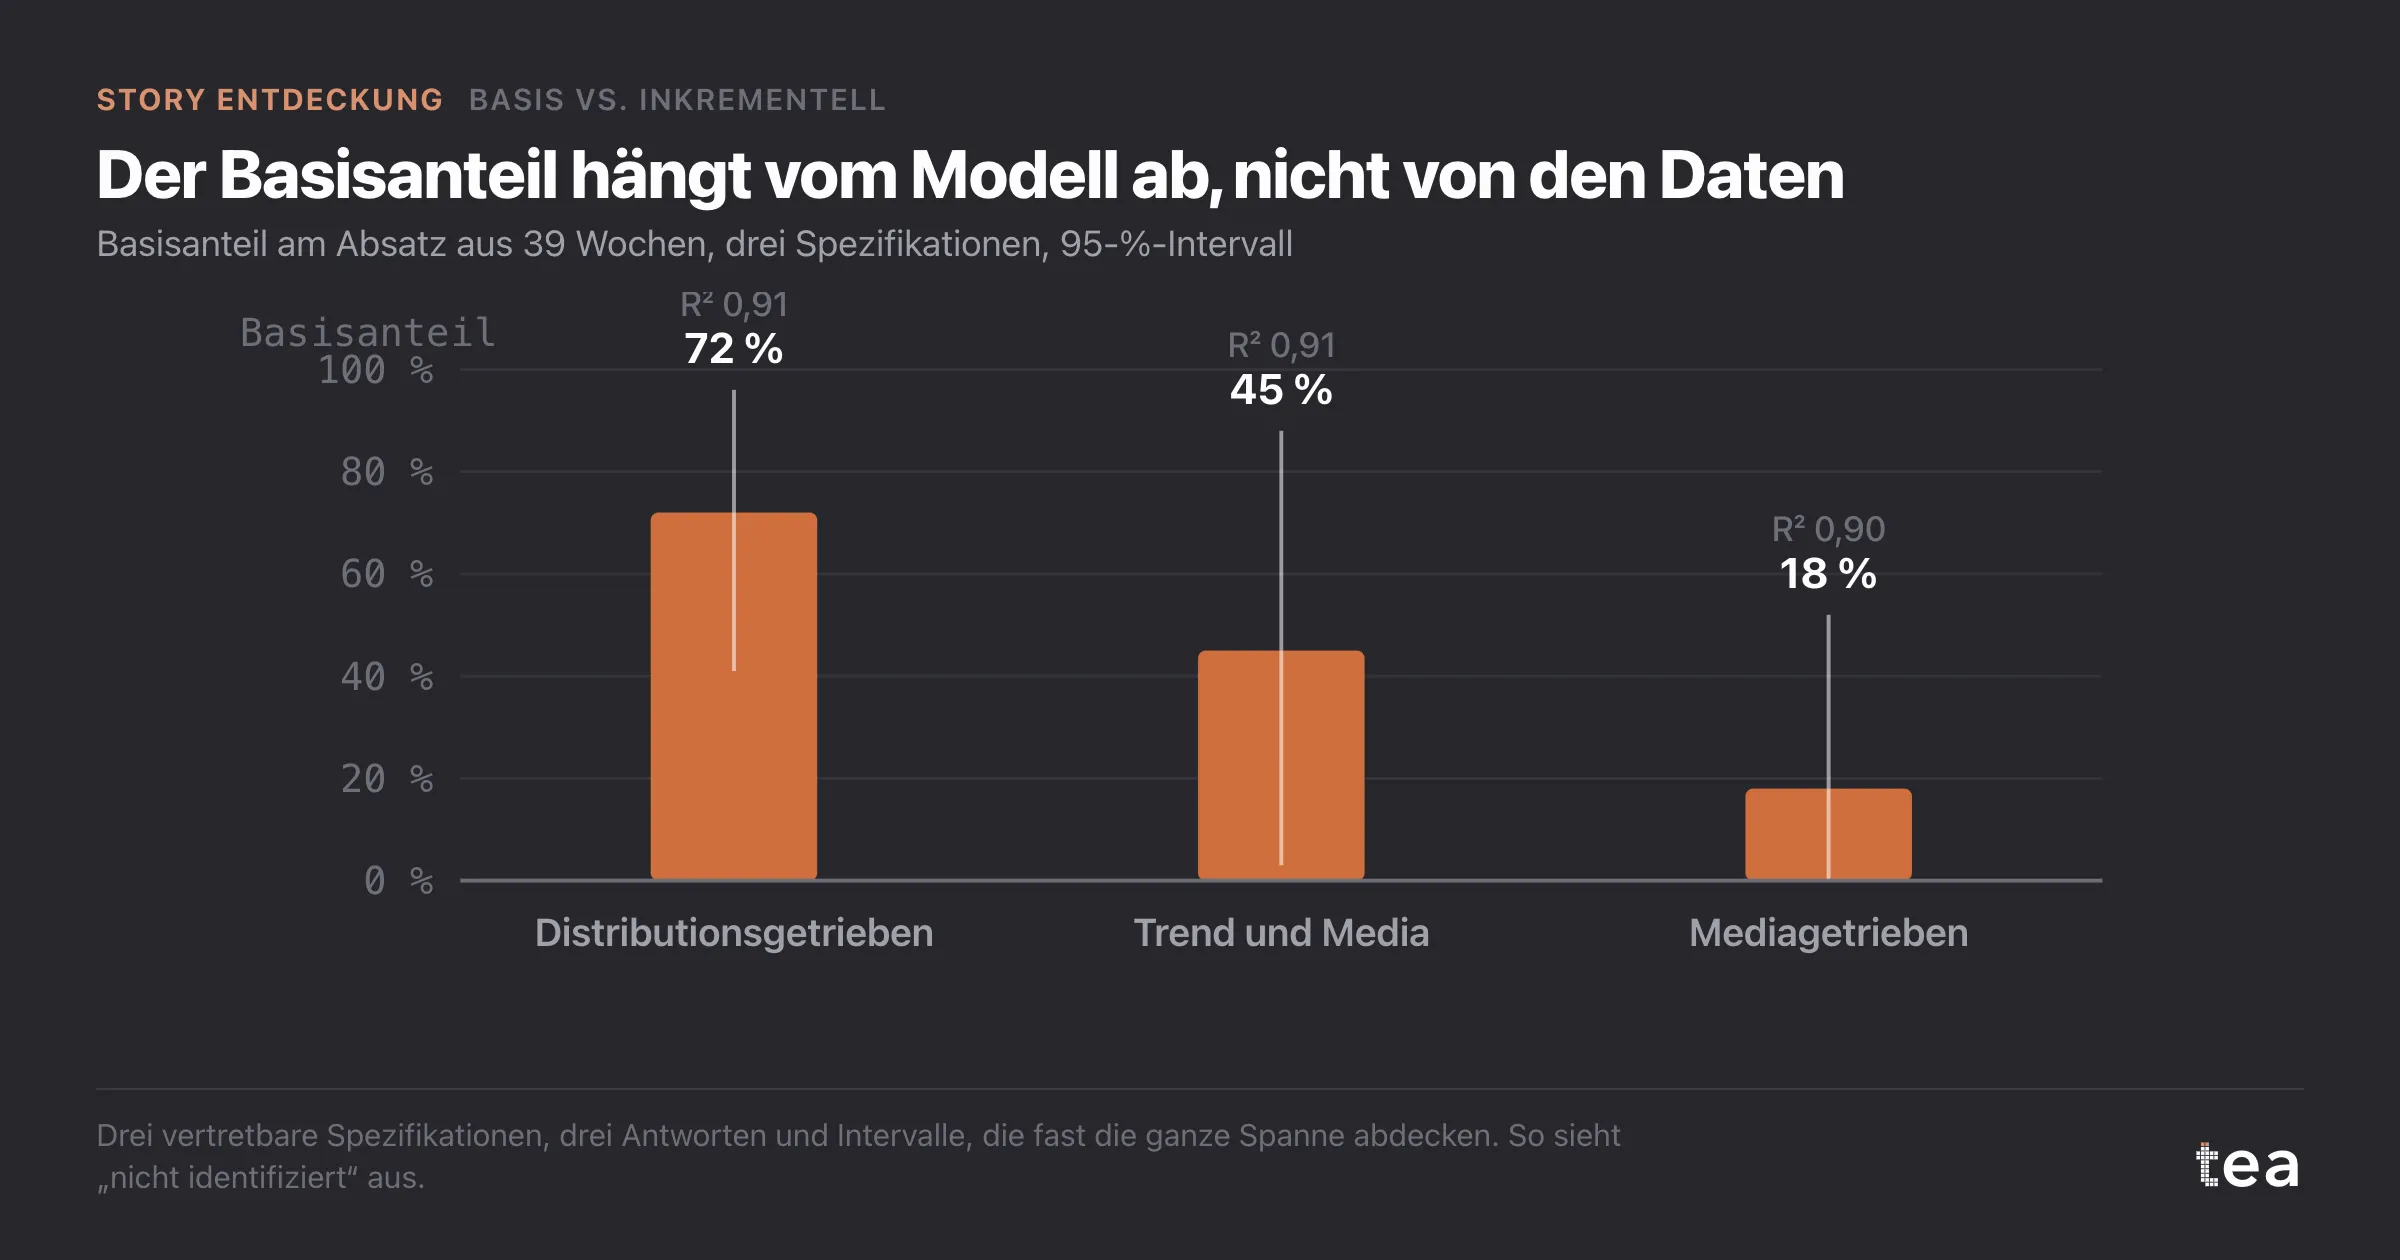
- distributionsgetrieben, die Filialzahl trägt den Anstieg und Media kommt obendrauf: R² 0,91, Basisanteil 72 %, Intervall 41 % bis 96 %;
- Trend und Media, mit einer Launch-Kurve für die Bekanntheit: R² 0,91, Basisanteil 45 %, Intervall 3 % bis 88 %;
- mediagetrieben, kumulierte Media baut die Marke auf: R² 0,90, Basisanteil 18 %, Intervall 0 % bis 52 %.
Alle drei bilden die Wochenlinie fast gleich gut ab. Keine der Diagnosen bevorzugt eines. Die Daten sind mit einer Marke, die vor allem auf ihren Listungen steht, genauso zufrieden wie mit einer Marke, die vor allem auf ihrer Werbung steht.
Das heißt „nicht identifiziert“. Es ist keine schwache Schätzung, die mehr Sorgfalt schärfen würde. Es ist eine Frage, für deren Antwort die Datei die Information nicht enthält.
Was schiefgegangen wäre, hätte man es erzwungen
Jede der drei Zahlen hätte man mit einem Diagramm und einer Nachkommastelle drucken können. Der Vorstand hätte dann, ohne es zu wissen, gewählt zwischen „Media halbieren, die Regale machen die Arbeit“ und „weiter ausgeben, die Marke ist die Werbung“. Jede davon ist eine vernünftige Strategie. Keine sollte gewählt werden, weil jemand zufällig diese Regression zuerst gerechnet hat.
Was stattdessen zu tun ist
Die Basis muss geschaffen werden, weil sie nie beobachtet wurde.
Holdout-Regionen. Schalten Sie Media in zwei der deutschen Nielsen-Gebiete für acht bis zehn Wochen ab, mit Filialzahlen, die dem Rest des Landes entsprechen, und lassen Sie sie anderswo weiterlaufen. Die Lücke zwischen den beiden Gruppen ist der inkrementelle Effekt, gemessen statt modelliert. Mit einer Regionsspalte in der Datei kann ein Geo-Modell dann lesen, was herauskommt.
Den nächsten Launch staffeln. Österreich und die Schweiz stehen für 2027 auf dem Plan. Stellen Sie das Produkt sechs bis acht Wochen ins Regal, bevor die Media startet. Diese Wochen sind die Basis für diesen Markt, und sie sagen auch über diesen hier einiges.
Die Ausgaben gezielt variieren. Auch ohne vollständigen Holdout geben bewusst schwache Wochen, ein paar mit 10.000 € statt 40.000 €, dem Modell einen tieferen Anker.
Warten, bis sich die Distribution setzt. Sobald die Filialzahl nicht mehr steigt, hört einer der drei Treiber auf, sich zu bewegen, und die beiden übrigen lassen sich leichter trennen.
Die Lehre
Eine Basis ist keine Zahl, die in Ihren Daten versteckt liegt. Sie ist eine Welt, die Ihre Daten besucht haben müssen. Wenn das Marketing ab dem ersten Tag lief, hat niemand diese Welt gesehen, und der ehrliche nächste Schritt ist, einen Besuch zu organisieren.
tea, das Produkt
Ihre Datei, diese Frage
Fünfzehn Analysen auf einer CSV mit Wochendaten, mit Intervallen und Diagnosen offen gezeigt, und einem klaren Satz, wenn die Daten keine Antwort hergeben. Kostenlos während der Beta, auf Einladung.
Einen Platz in der Beta anfragen→tea, das Produkt
Fünfzehn ökonometrische Analysen auf Ihrer eigenen CSV: Basis vs. Inkrementell, Sättigungskurven, Elastizitäten, Budgetaufteilung. Intervalle und Diagnosen offen gezeigt, und ein klarer Satz, wenn die Datei keine Antwort hergibt.
Kostenlos während der Beta, auf Einladung.
Einen Platz in der Beta anfragen →Hat es Ihnen gefallen? Probieren Sie es mit Ihren eigenen Daten.
tea führt Basis vs. Inkrementell und vierzehn weitere Analysen auf jeder CSV mit Wochendaten aus, in Minuten. Kostenlos während der Beta, auf Einladung.
Die Story Entdeckung
- Trendanalyse mit Strukturbruch, und warum eine Linie lügt
- Abo-Wachstum durch Marketing, oder ein Trend, der schon da war
- Ostern, Vorjahresvergleiche und das Quartal, das nicht fiel
- Kollinearität von TV und Brand Search hebelt die Regression aus
- Absatzspitze den Influencern zugeschrieben, nach Treibern zerlegt
- Wie hoch wäre der Umsatz ohne Marketing? Das kontrafaktische Jahr
- Basis vs. Inkrementell nach einem Launch, ohne Basis in den Daten