Französische Direct-to-Consumer-Matratzenmarke, 104 Wochen Umsatz und Media, mit der Frage, wie viel Umsatz von TV und wie viel von Brand Search kommt.
Ein zusammengesetzter Fall, gebaut aus der Art von Datei, die wir fast jede Woche sehen. Eine Direct-to-Consumer-Matratzenmarke in Frankreich, rund 31 Mio. € Onlineumsatz, mit einer TV-Agentur und einer Search-Agentur, die beide eine Folie hatten, auf der das Jahr ihnen gehörte.
Die Frage der Marketingdirektorin: „Wie viel unseres Absatzes kommt von TV und wie viel von Brand Search? Ich brauche vor der Budgetrunde eine Zahl für jeden.“
Es ist die natürlichste Frage der Story Entdeckung, und in dieser Datei hatte sie keine Antwort.
Wie die Datei aussah
104 Wochenzeilen, zwei Jahre. Umsatz, TV-GRP, Ausgaben für Brand Search, generische Suche, Paid Social, ein Promotionkennzeichen und die Trend- und Saisonterme aus den früheren Schritten der Story Entdeckung, samt Oster-Dummy wie im Fall der Süßwaren. TV lief in Flights: zwölf Wochen an, sechs Wochen aus, rund 2,6 Mio. € über den Zeitraum. Brand Search kostete rund 1,13 Mio. €.
Das Detail, das alles entschied, steckte in der Gebotsregel der Search-Agentur. Während der TV-Flights stiegen die Gebote auf den Markennamen, denn wer den Spot sieht, sucht nach der Marke, und niemand wollte, dass ein Wettbewerber diesen Klick bekommt. Vernünftige Mediapraxis. Tödlich für die Messung.
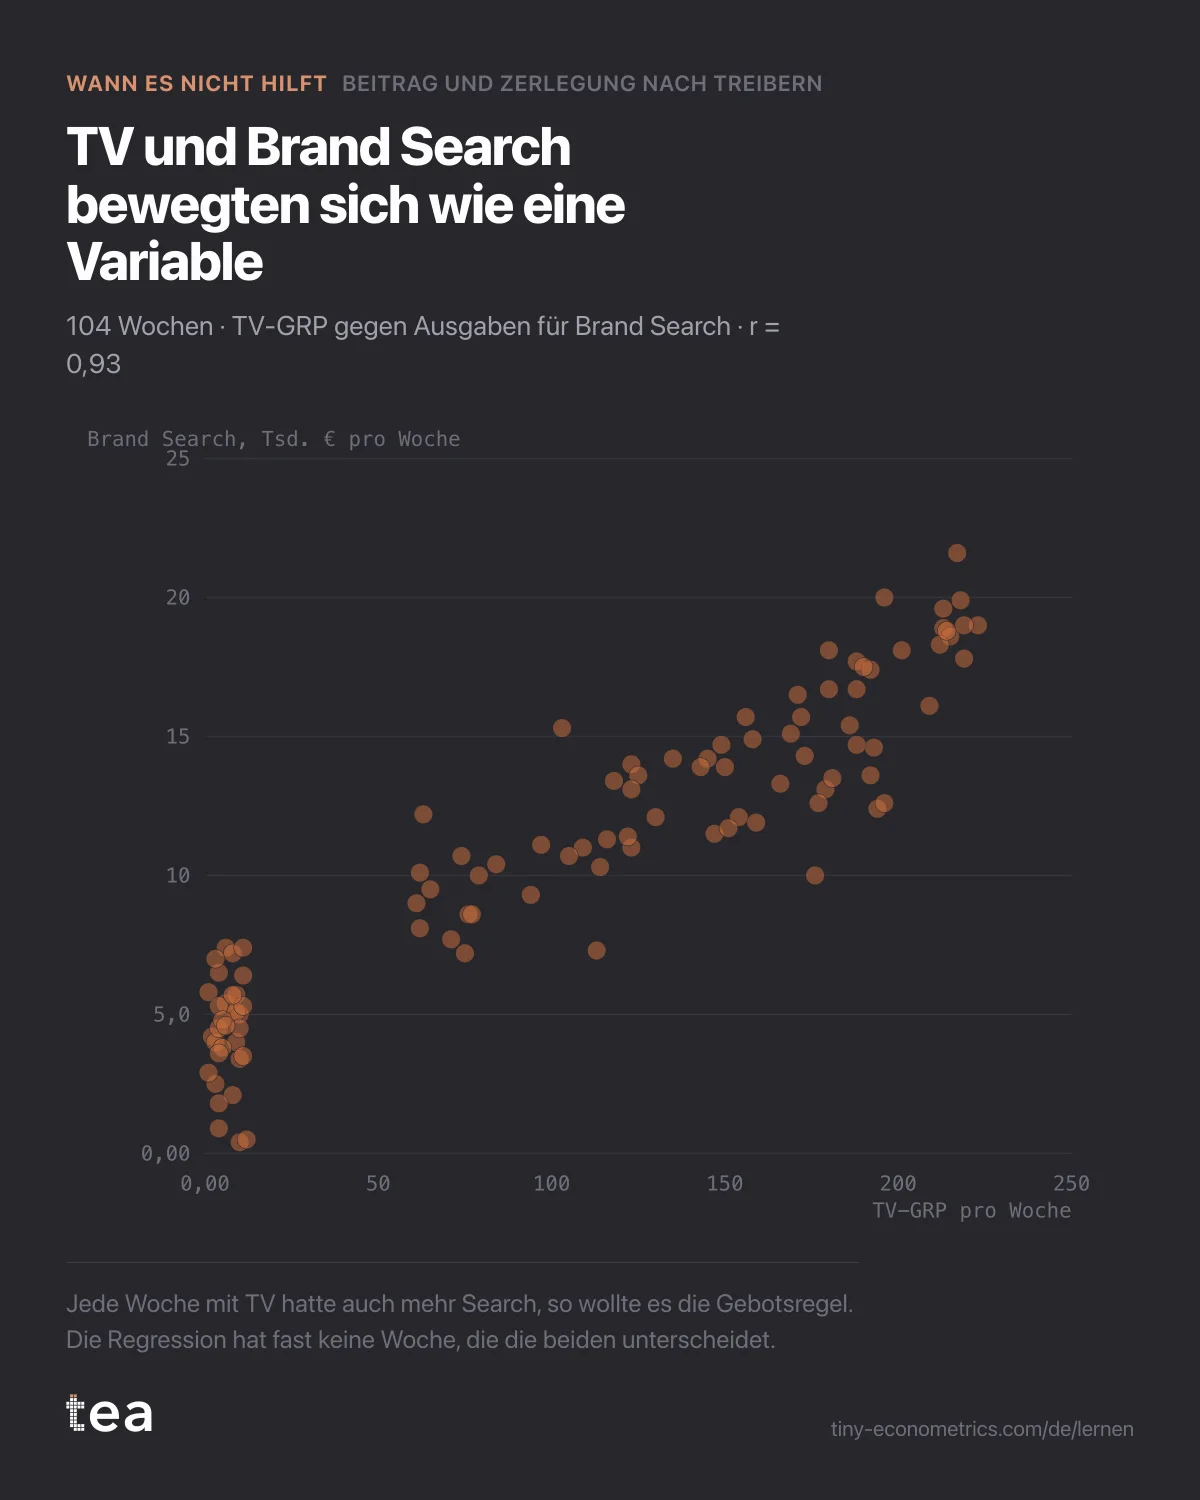
Über die 104 Wochen korrelieren TV-GRP und Ausgaben für Brand Search mit r = 0,93. Ging das eine hoch, ging das andere hoch. War TV aus, sank Search. Es gibt fast keine Woche, in der sich die beiden auseinander bewegten.
Was die Regression nicht konnte
Beitrag und Zerlegung nach Treibern schätzt eine Regression des Umsatzes auf alle Treiber zugleich, mit Adstock auf TV, damit ein Flight nach seinem Ende weiterwirkt. Jeder Koeffizient ist die Wirkung eines Treibers, während die anderen stillgehalten werden.
Dieser Halbsatz, während die anderen stillgehalten werden, ist das ganze Problem. Das Modell lernt, was TV tut, aus Wochen, in denen TV sich bewegte und Search nicht. Diese Datei hat fast keine solchen Wochen. Das Modell sieht also, dass „TV plus Search“ den Umsatz bewegt hat, und es sieht nicht, wie es die Anerkennung aufteilen soll.
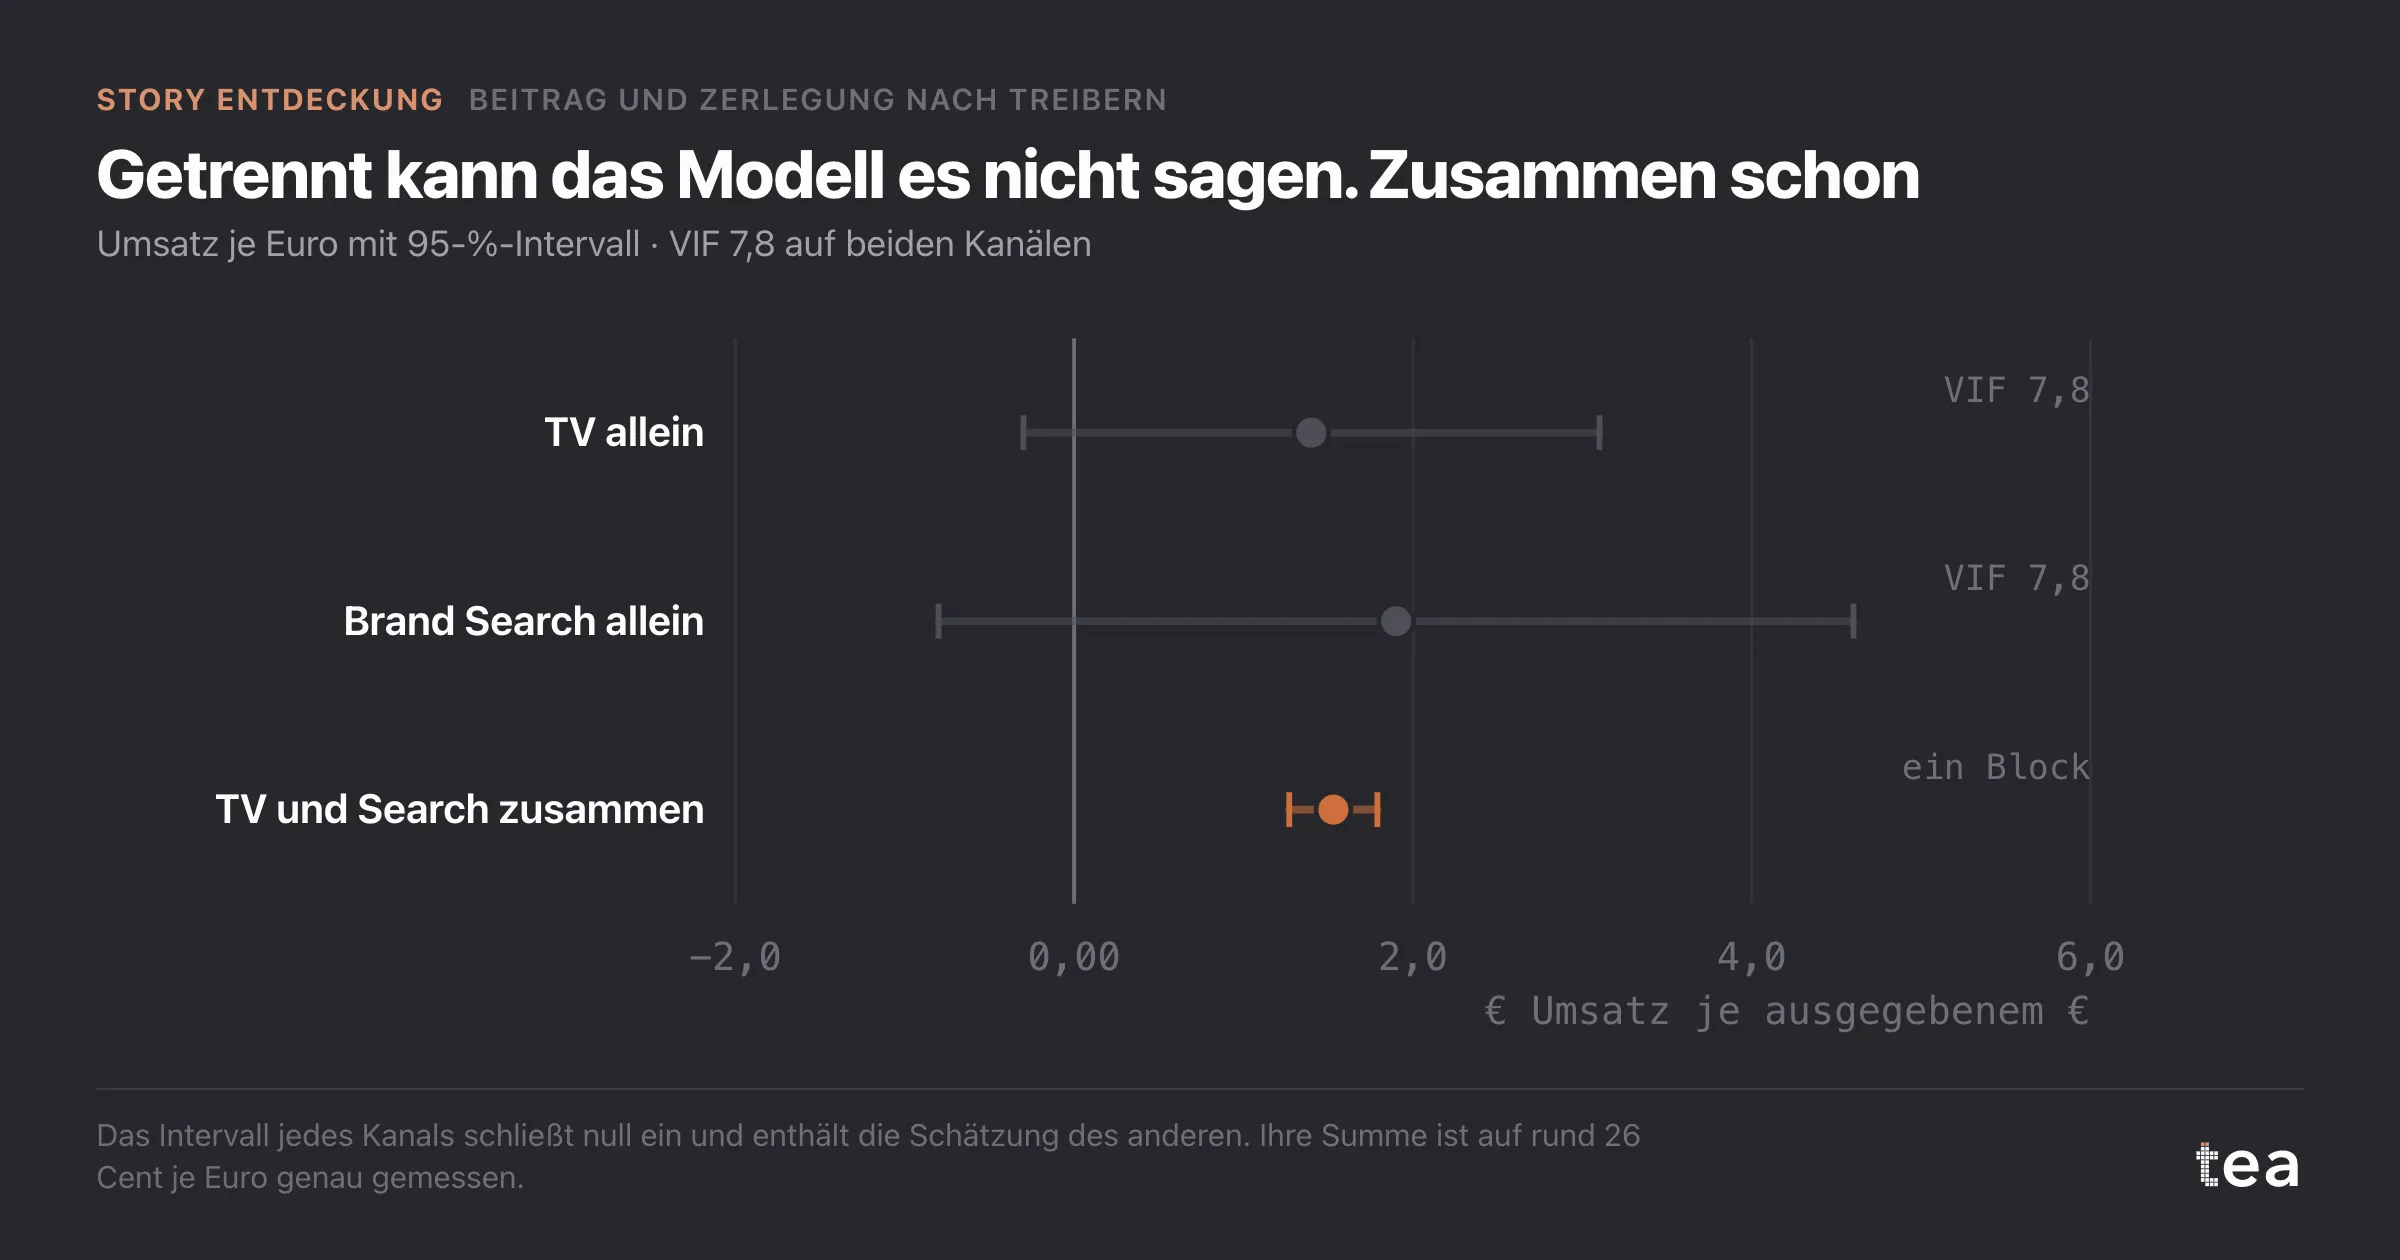
Die Diagnose dafür ist der Varianzinflationsfaktor. Auf beiden Kanälen lag er bei 7,8. Einfach gesagt: Die Unsicherheit jedes Koeffizienten ist rund 2,8-mal breiter, als sie es wäre, wenn sich die beiden Kanäle unabhängig bewegt hätten, denn die Wurzel aus 7,8 ist 2,8.
Die Intervalle zeigen es:
- TV: 1,40 € Umsatz je Euro, 95-%-Intervall von -0,30 € bis 3,10 €;
- Brand Search: 1,90 € je Euro, Intervall von -0,80 € bis 4,60 €;
- beide zusammen: 1,53 € je Euro, Intervall von 1,27 € bis 1,79 €.
Das Intervall jedes Kanals schließt null ein und enthält die Schätzung des anderen Kanals. Ihre Summe ist auf rund 26 Cent genau gemessen. Die Daten wissen, was das Paar getan hat. Sie wissen nicht, wer es war.
Was beim Erzwingen schiefgegangen wäre
Die Punktschätzungen sagen, dass Search mehr bringt als TV. Wörtlich gelesen legen sie nahe, Geld von TV zu Search zu verschieben. Nehmen Sie acht Wochen aus der Stichprobe und schätzen Sie neu, und die Rangfolge kippt. Zwei Personen, die dieselbe Analyse auf leicht verschiedenen Zeiträumen ausführen, kämen mit entgegengesetzten Empfehlungen in dieselbe Besprechung, beide mit einer Regression im Rücken.
Schlimmer noch: Die Lesart „Search gewinnt“ steht im Mechanismus wahrscheinlich auf dem Kopf. Wenn TV Menschen dazu bringt, nach der Marke zu suchen, dann hat TV einen Teil dessen erzeugt, was Brand Search einsammelt. Eine Kürzung bei TV würde dann auch das Volumen von Brand Search senken, und das Modell, trainiert auf einer Welt, in der sich beide immer gemeinsam bewegten, hätte niemanden gewarnt.
Was stattdessen zu tun ist
Zusammenfassen. Berichten Sie TV und Brand Search als einen Block, 1,53 € je Euro mit seinem engen Intervall, und planen Sie beide gemeinsam. Das ist eine weniger aufregende Antwort, und es ist die wahre.
Ein Vorwissen aus einem Test mitbringen. Ein Holdout für Brand Search, bei dem die Gebote auf den Markennamen in einigen Regionen für vier bis sechs Wochen pausieren, misst, wie viel dieses Traffics auch organisch gekommen wäre. Diese Zahl kann dann einen Koeffizienten festlegen, und die Regression muss nur noch den anderen schätzen.
Die Korrelation absichtlich brechen. Entkoppeln Sie für die nächsten zwei Flights die Gebotsregel: Halten Sie die Markengebote in abwechselnden Wochen konstant, oder lassen Sie einen Flight mit unverändertem Search laufen. Zwölf bis sechzehn Wochen unabhängiger Bewegung reichen meist, damit der Varianzinflationsfaktor unter 3 fällt.
TEA führt den Test nicht durch. Es liest die Datei, die dabei herauskommt.
Die Lehre
Eine Regression kann nur Treiber trennen, die die Daten trennen. Wenn zwei Kanäle gemeinsam geplant werden, werden sie auch gemeinsam gemessen. Wenn Sie wissen wollen, was jeder einzelne tut, muss sich einer von beiden allein bewegen, ab und zu, mit Absicht.
tea, das Produkt
Ihre Datei, diese Frage
Fünfzehn Analysen auf einer CSV mit Wochendaten, mit Intervallen und Diagnosen offen gezeigt, und einem klaren Satz, wenn die Daten keine Antwort hergeben. Kostenlos während der Beta, auf Einladung.
Einen Platz in der Beta anfragen→tea, das Produkt
Fünfzehn ökonometrische Analysen auf Ihrer eigenen CSV: Beitrag und Zerlegung nach Treibern, Sättigungskurven, Elastizitäten, Budgetaufteilung. Intervalle und Diagnosen offen gezeigt, und ein klarer Satz, wenn die Datei keine Antwort hergibt.
Kostenlos während der Beta, auf Einladung.
Einen Platz in der Beta anfragen →Hat es Ihnen gefallen? Probieren Sie es mit Ihren eigenen Daten.
tea führt Beitrag und Zerlegung nach Treibern und vierzehn weitere Analysen auf jeder CSV mit Wochendaten aus, in Minuten. Kostenlos während der Beta, auf Einladung.
Die Story Entdeckung
- Trendanalyse mit Strukturbruch, und warum eine Linie lügt
- Abo-Wachstum durch Marketing, oder ein Trend, der schon da war
- Ostern, Vorjahresvergleiche und das Quartal, das nicht fiel
- Kollinearität von TV und Brand Search hebelt die Regression aus
- Absatzspitze den Influencern zugeschrieben, nach Treibern zerlegt
- Wie hoch wäre der Umsatz ohne Marketing? Das kontrafaktische Jahr (erscheint am 22. Oktober 2026)
- Basis vs. Inkrementell nach einem Launch, ohne Basis in den Daten (erscheint am 27. Oktober 2026)