Eine Beitragsgrafik ist eine Sammlung von Punktschätzungen. Diese Grafik sagt Ihnen, ob Sie ihnen glauben sollten.
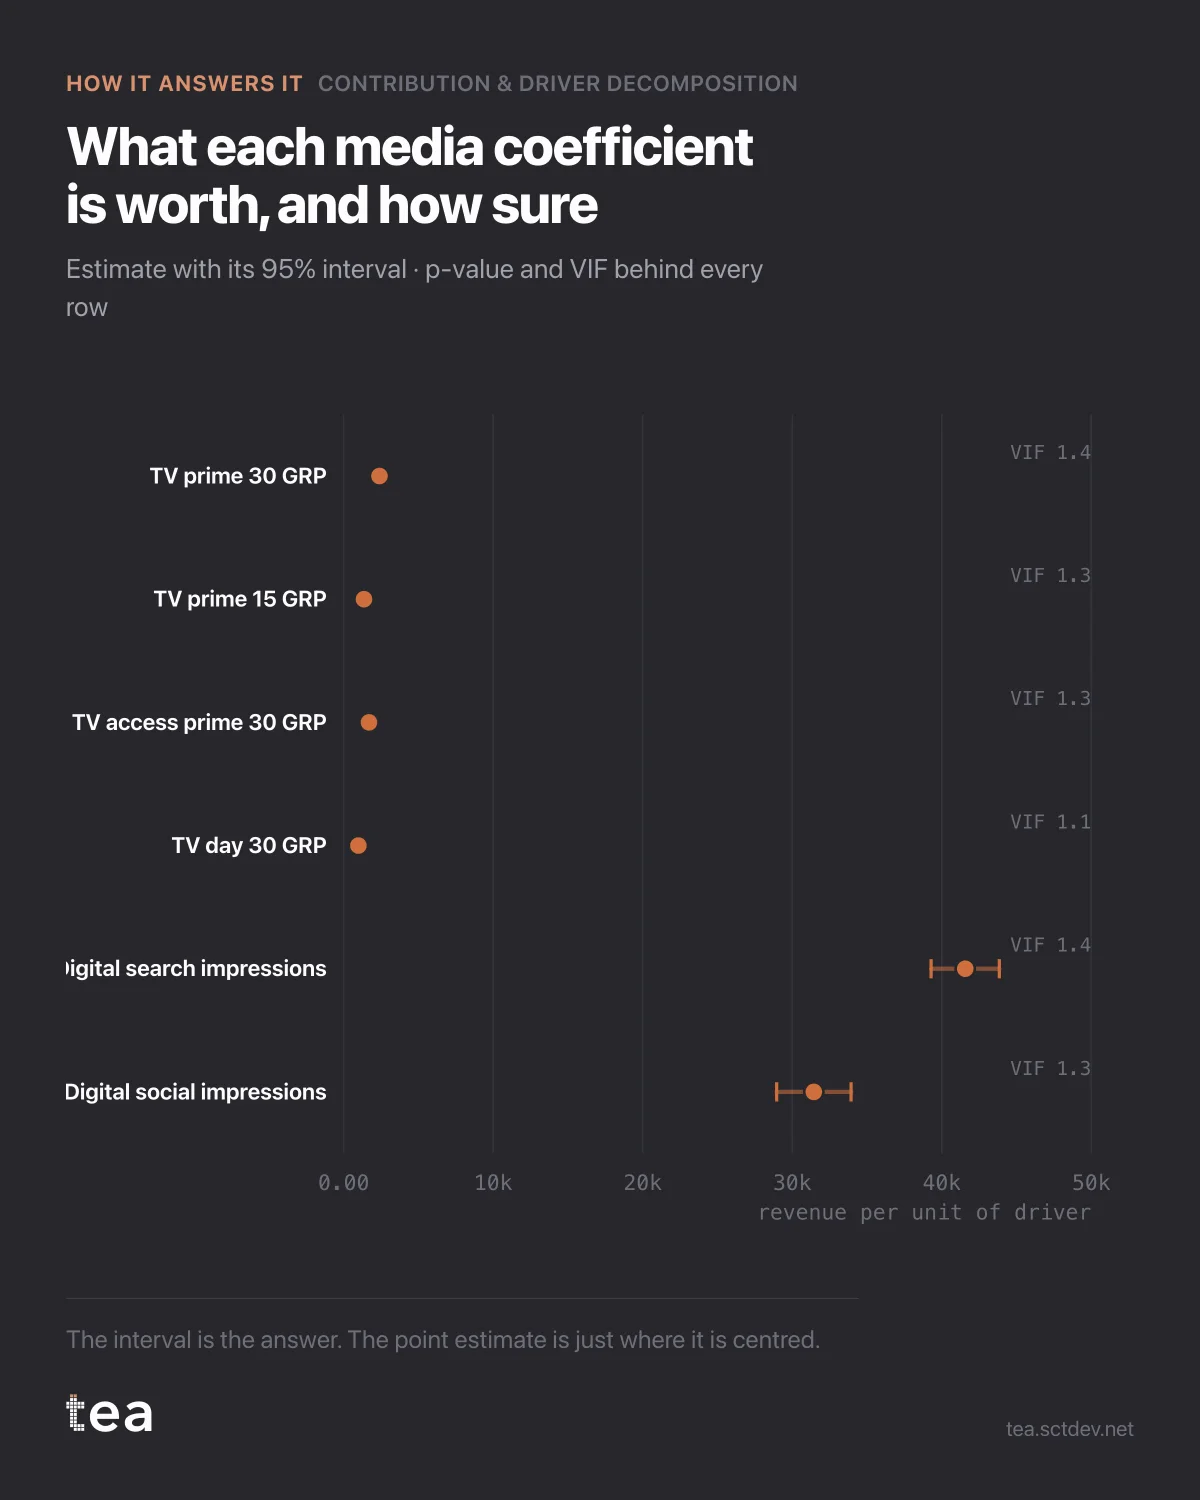
Jede Zeile ist ein Mediakoeffizient mit seinem 95-%-Intervall: was eine Einheit mehr dieses Treibers wert ist und wie weit sich die Daten auf die Zahl festlegen.
Das Lesen ist mechanisch. Ein Intervall, das deutlich von der Null entfernt liegt, ist ein Treiber, mit dem Sie planen können. Ein Intervall, das die Null überspannt, ist ein Treiber, dessen Wirkung die Daten nicht von nichts unterscheiden können, ganz gleich, wie der Balken in der Beitragsgrafik aussah.
Hier liegt jedes Mediaintervall klar von der Null entfernt. So sieht eine saubere Datei mit echter Variation im Flighting aus. Das ist der gute Fall, und es lohnt sich zu wissen, was ihn möglich macht, statt ihn für normal zu halten.
Vier Dinge stehen hinter diesen Intervallen:
Der Standardfehler. TV Prime 30 kommt auf 2.396 Umsatz je GRP mit einem Standardfehler von 58. Das ist eine enge Schätzung. Digital Search mit 41.570 und einem Standardfehler von 1.165 ist im Verhältnis ebenso eng. Die Punktschätzungen sind nicht vertrauenswürdiger als ihre Fehler.
Der p-Wert, der je Koeffizient ausgewiesen wird und nicht für das Modell als Ganzes. Ein Modell mit exzellentem R² kann Treiber enthalten, die nichts Messbares beitragen, und die Gesamtanpassung wird Ihnen nie sagen, welche.
Der VIF, der unauffälligste der vier. Er misst, wie stark der Fehler jedes Treibers dadurch aufgebläht wird, dass er mit den anderen korreliert. Das Maximum liegt hier bei 1,9, und das ist entspannt. Über 5 beginnen die Koeffizienten, untereinander die Plätze zu tauschen, und über 10 lassen sich die einzelnen Zahlen nicht mehr trennen, obwohl die Summe stimmt. Das ist der Unterschied zwischen einem Modell, das funktioniert, und einem Modell, dessen Einzelteile man zitieren kann.
Und das Verhalten der Residuen. Ein Durbin-Watson von 2,35 auf 103 Wochen sagt, dass die Reste nicht stark autokorreliert sind, und genau unter dieser Bedingung bedeuten diese Intervalle, was sie sagen.
Das R² liegt bei 0,995, der MAPE bei 0,52 %. Diese Zahlen sehen wunderbar aus und beweisen für sich genommen fast nichts: Ein Modell kann die Historie wunderschön nachzeichnen und trotzdem nicht in der Lage sein, sie zuzuordnen. Über die Attribution entscheidet die Koeffiziententabelle.
Die Gewohnheit, die sich lohnt, ist klein. Wenn Ihnen jemand eine Beitragsgrafik zeigt, fragen Sie nach dieser hier. Gibt es sie nicht, ist die Beitragsgrafik eine Sammlung von Zahlen mit unbekannten Fehlerbalken, und die Größe eines Balkens sagt Ihnen nichts darüber, ob der Treiber dahinter echt ist.
Sie ist auch der schnellste Weg, ein Modell zu erkennen, das überspezifiziert wurde, damit es gut aussieht. Zwanzig Treiber, ein wunderschönes R² und die Hälfte der Intervalle schließt die Null ein: Das ist kein starkes Modell mit ein paar schwachen Teilen. Es ist ein Modell, das das Rauschen geschätzt hat und das Verdienst nach Zufall verteilt.
Die Grafik ist die echte Ausgabe von Beitrag und Zerlegung nach Treibern in TEA. Intervall, p-Wert und VIF kommen mit jedem Treiber.
tea, das Produkt
Ihre Datei, diese Frage
Fünfzehn Analysen auf einer CSV mit Wochendaten, mit Intervallen und Diagnosen offen gezeigt, und einem klaren Satz, wenn die Daten keine Antwort hergeben. Kostenlos während der Beta, auf Einladung.
Einen Platz in der Beta anfragen→tea, das Produkt
Fünfzehn ökonometrische Analysen auf Ihrer eigenen CSV: Beitrag und Zerlegung nach Treibern, Sättigungskurven, Elastizitäten, Budgetaufteilung. Intervalle und Diagnosen offen gezeigt, und ein klarer Satz, wenn die Datei keine Antwort hergibt.
Kostenlos während der Beta, auf Einladung.
Einen Platz in der Beta anfragen →Hat es Ihnen gefallen? Probieren Sie es mit Ihren eigenen Daten.
tea führt Beitrag und Zerlegung nach Treibern und vierzehn weitere Analysen auf jeder CSV mit Wochendaten aus, in Minuten. Kostenlos während der Beta, auf Einladung.