C’est le graphique qui vous dit si une prévision est terminée, et presque personne ne le regarde.
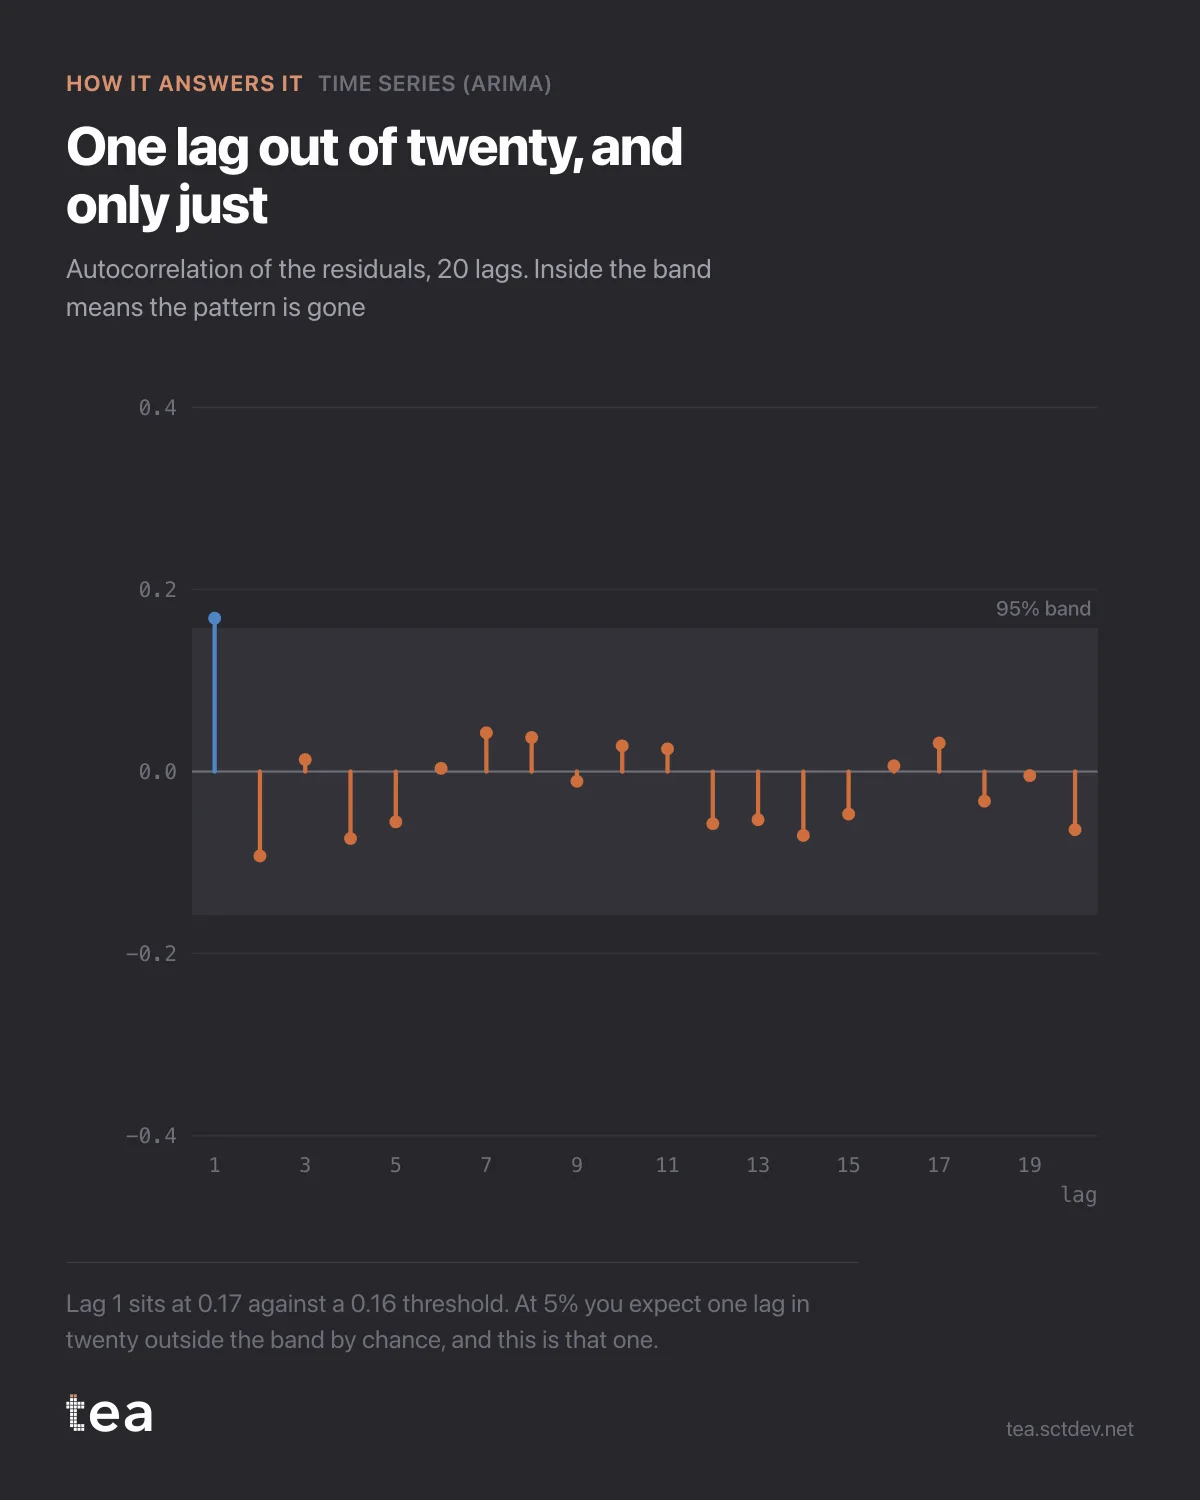
C’est l’autocorrélation des résidus : ce que le modèle n’a pas su expliquer, examiné pour voir s’il garde une forme. Vingt retards, et une bande qui marque où se situerait un bruit aléatoire.
La logique est simple. Si les restes portent encore un motif, le modèle n’a pas fini son assiette. Un pic au retard 52 sur des données hebdomadaires signifie qu’une saison annuelle n’a pas été prise. Une décroissance lente sur les premiers retards signifie que le terme d’élan est trop faible. Dans les deux cas, il reste du signal par terre, et sa place est dans la prévision plutôt que dans l’erreur.
Ici, un retard sur vingt dépasse la ligne. Le retard 1 est à 0,17 pour un seuil de 0,16.
Maintenant, la partie qui mérite d’être dite à voix haute, parce que c’est là que le reporting devient malhonnête, dans les deux sens.
Avec une bande à 95 %, on s’attend à ce qu’un retard sur vingt en sorte par hasard. C’est ce que signifie la bande. Un dépassement marginal au premier retard n’est pas la preuve d’un problème, et ce n’est pas non plus quelque chose à cacher. C’est le coût attendu quand on teste vingt choses à la fois.
Ce qui changerait le verdict, c’est un motif : plusieurs retards dehors, ou un seul retard important à une position saisonnière, ou le même retard dehors d’une spécification à l’autre. Rien de tout cela ici.
Les résidus sont donc assez proches du bruit pour faire confiance à l’intervalle, et c’est toute la raison de ce contrôle. La bande de confiance de la prévision est calculée comme si les résidus se comportaient bien. S’ils ne se comportent pas bien, la bande est trop étroite, et une bande trop étroite est pire que pas de bande du tout, parce qu’elle invite à une décision que les données ne peuvent pas soutenir.
C’est la partie de la prévision qui ne tient pas dans un titre. Un chiffre, c’est facile. Un chiffre que vous pouvez défendre demande quatre graphiques de plus, et celui-ci en fait partie.
TEA lance les diagnostics des résidus avec l’ajustement et les affiche à côté de la prévision, pas sur demande, parce qu’une prévision sans eux est une opinion avec des décimales.
Si vous ne retenez qu’une habitude de ce billet, prenez celle-ci. Quand quelqu’un vous remet une prévision, demandez à quoi ressemblent les résidus. Si la réponse est un haussement d’épaules, l’intervalle de cette prévision est de la décoration, et c’est précisément avec l’intervalle que vous alliez décider.
C’est aussi le contrôle le moins cher de toute la chaîne. L’ajustement est déjà calculé, les résidus existent déjà, et le test consiste à comparer vingt nombres à une ligne. S’il saute, ce n’est pas une question de coût : c’est que personne ne le demande.
Le graphique est le résultat réel du module Séries temporelles (ARIMA) dans TEA.
tea, le produit
Votre fichier, cette question
Quinze analyses sur un CSV de données hebdomadaires, avec les intervalles et les diagnostics sous les yeux, et une phrase claire quand les données ne peuvent pas répondre. Gratuit pendant la bêta, sur invitation.
Demander une place dans la bêta→tea, le produit
Quinze analyses économétriques sur votre propre CSV : Séries temporelles (ARIMA), courbes de saturation, élasticités, allocation budgétaire. Les intervalles et les diagnostics sous les yeux, et une phrase claire quand le fichier ne peut pas répondre.
Gratuit pendant la bêta, sur invitation.
Demander une place dans la bêta →Cet article vous a plu ? Lancez l’analyse sur vos propres données.
TEA lance Séries temporelles (ARIMA) et quatorze autres analyses sur n’importe quel CSV hebdomadaire, en quelques minutes. Gratuit pendant la bêta, sur invitation.