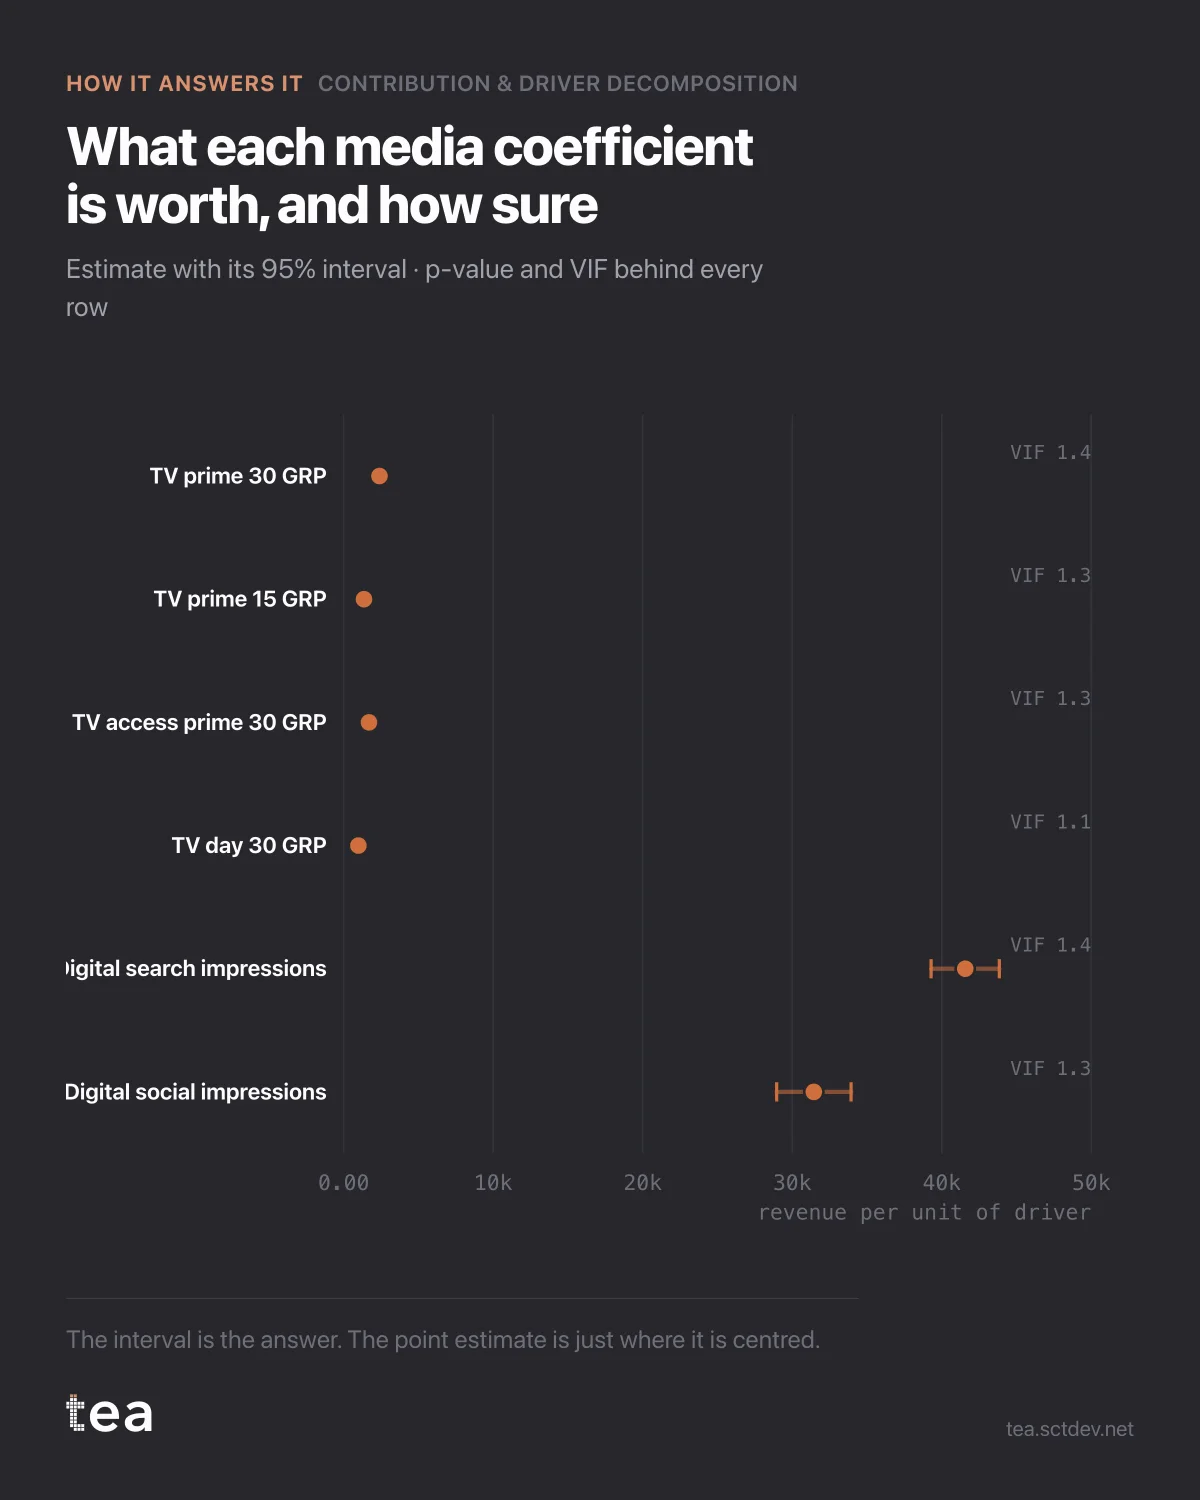
Un graphique de contribution est un ensemble d’estimations ponctuelles. Voici le graphique qui vous dit s’il faut y croire.
Chaque ligne est un coefficient média avec son intervalle à 95 % : ce que vaut une unité de plus de ce levier, et à quel point les données sont prêtes à s’engager sur ce chiffre.
La lecture est mécanique. Un intervalle bien à l’écart de zéro est un levier sur lequel vous pouvez planifier. Un intervalle à cheval sur zéro est un levier dont les données ne savent pas distinguer l’effet de rien du tout, quelle que soit l’allure de sa barre dans le graphique de contribution.
Ici, tous les intervalles média sont à l’écart de zéro : c’est l’allure d’un fichier propre, avec une vraie variation des vagues. C’est le bon cas, et il vaut la peine de savoir ce qui le rend possible plutôt que de le supposer normal.
Quatre éléments derrière ces intervalles :
L’erreur type. TV prime 30 ressort à 2 396 de chiffre d’affaires par GRP, avec une erreur type de 58. C’est une estimation serrée. Digital search, à 41 570 avec une erreur type de 1 165, est serré aussi, en proportion. Les estimations ponctuelles ne sont pas plus fiables que leurs erreurs.
La p-value, publiée pour chaque coefficient plutôt que pour le modèle dans son ensemble. Un modèle avec un excellent R² peut contenir des leviers qui n’apportent rien de mesurable, et l’ajustement global ne vous dira jamais lesquels.
Le VIF, le plus discret des quatre. Il mesure à quel point l’erreur de chaque levier est gonflée par sa corrélation avec les autres. Le maximum ici est de 1,9, ce qui est confortable. Au-dessus de 5, les coefficients commencent à échanger leurs places, et au-dessus de 10, les chiffres individuels ne sont plus séparables même si le total est bon. C’est la différence entre un modèle qui fonctionne et un modèle dont on peut citer les parties.
Et le comportement des résidus. Un Durbin-Watson à 2,35 sur 103 semaines dit que les restes ne sont pas fortement autocorrélés, la condition pour que ces intervalles signifient ce qu’ils disent.
Le R² est de 0,995 et le MAPE de 0,52 %. Ces chiffres ont l’air magnifiques et ne prouvent presque rien à eux seuls : un modèle peut épouser l’historique à merveille et rester incapable de l’attribuer. C’est dans la table des coefficients que se décide l’attribution.
L’habitude à prendre est minime. Quand quelqu’un vous montre un graphique de contribution, demandez celui-ci. S’il n’existe pas, le graphique de contribution est un ensemble de chiffres aux barres d’erreur inconnues, et la taille d’une barre ne vous dit rien sur la réalité du levier qui est derrière.
C’est aussi le moyen le plus rapide de repérer un modèle surspécifié pour faire bonne impression. Vingt leviers, un superbe R² et la moitié des intervalles qui croisent zéro, ce n’est pas un modèle solide avec quelques points faibles. C’est un modèle qui a ajusté le bruit et qui répartit le mérite au hasard.
Le graphique est le résultat réel du module Contribution et décomposition par levier dans TEA. L’intervalle, la p-value et le VIF accompagnent chaque levier.
tea, le produit
Votre fichier, cette question
Quinze analyses sur un CSV de données hebdomadaires, avec les intervalles et les diagnostics sous les yeux, et une phrase claire quand les données ne peuvent pas répondre. Gratuit pendant la bêta, sur invitation.
Demander une place dans la bêta→tea, le produit
Quinze analyses économétriques sur votre propre CSV : Contribution et décomposition par levier, courbes de saturation, élasticités, allocation budgétaire. Les intervalles et les diagnostics sous les yeux, et une phrase claire quand le fichier ne peut pas répondre.
Gratuit pendant la bêta, sur invitation.
Demander une place dans la bêta →Cet article vous a plu ? Lancez l’analyse sur vos propres données.
TEA lance Contribution et décomposition par levier et quatorze autres analyses sur n’importe quel CSV hebdomadaire, en quelques minutes. Gratuit pendant la bêta, sur invitation.