Marque française de matelas vendue en direct, 104 semaines de ventes et de médias, qui voulait savoir quelle part du chiffre d’affaires venait de la TV et quelle part du search de marque.
Un cas composite, construit à partir du genre de fichier que nous voyons presque chaque semaine. Une marque française de matelas vendue en direct, environ 31 M€ de chiffre d’affaires en ligne, avec une agence TV et une agence search qui avaient chacune une slide expliquant que l’année leur revenait.
La question de la directrice marketing : « Quelle part de nos ventes vient de la TV, et quelle part du search de marque ? Il me faut un chiffre pour chacun avant les arbitrages budgétaires. »
C’est la question la plus naturelle du Récit de découverte, et sur ce fichier elle n’avait pas de réponse.
À quoi ressemblait le fichier
104 lignes hebdomadaires, deux ans. Chiffre d’affaires, GRP TV, dépenses en search de marque, search générique, social payant, un indicateur de promotion, et les termes de tendance et de saisonnalité repris des étapes précédentes du parcours, variable muette de Pâques comprise, comme dans le cas de la confiserie. La TV tournait par vagues : douze semaines d’antenne, six semaines de pause, environ 2,6 M€ sur la période. Le search de marque avait coûté environ 1,13 M€.
Le détail qui a tout décidé se trouvait dans la règle d’enchères de l’agence search. Pendant les vagues TV, les enchères sur le nom de la marque montaient, parce que les gens qui voient le spot cherchent la marque et que personne ne voulait laisser ce clic à un concurrent. Une pratique média sensée. Fatale pour la mesure.
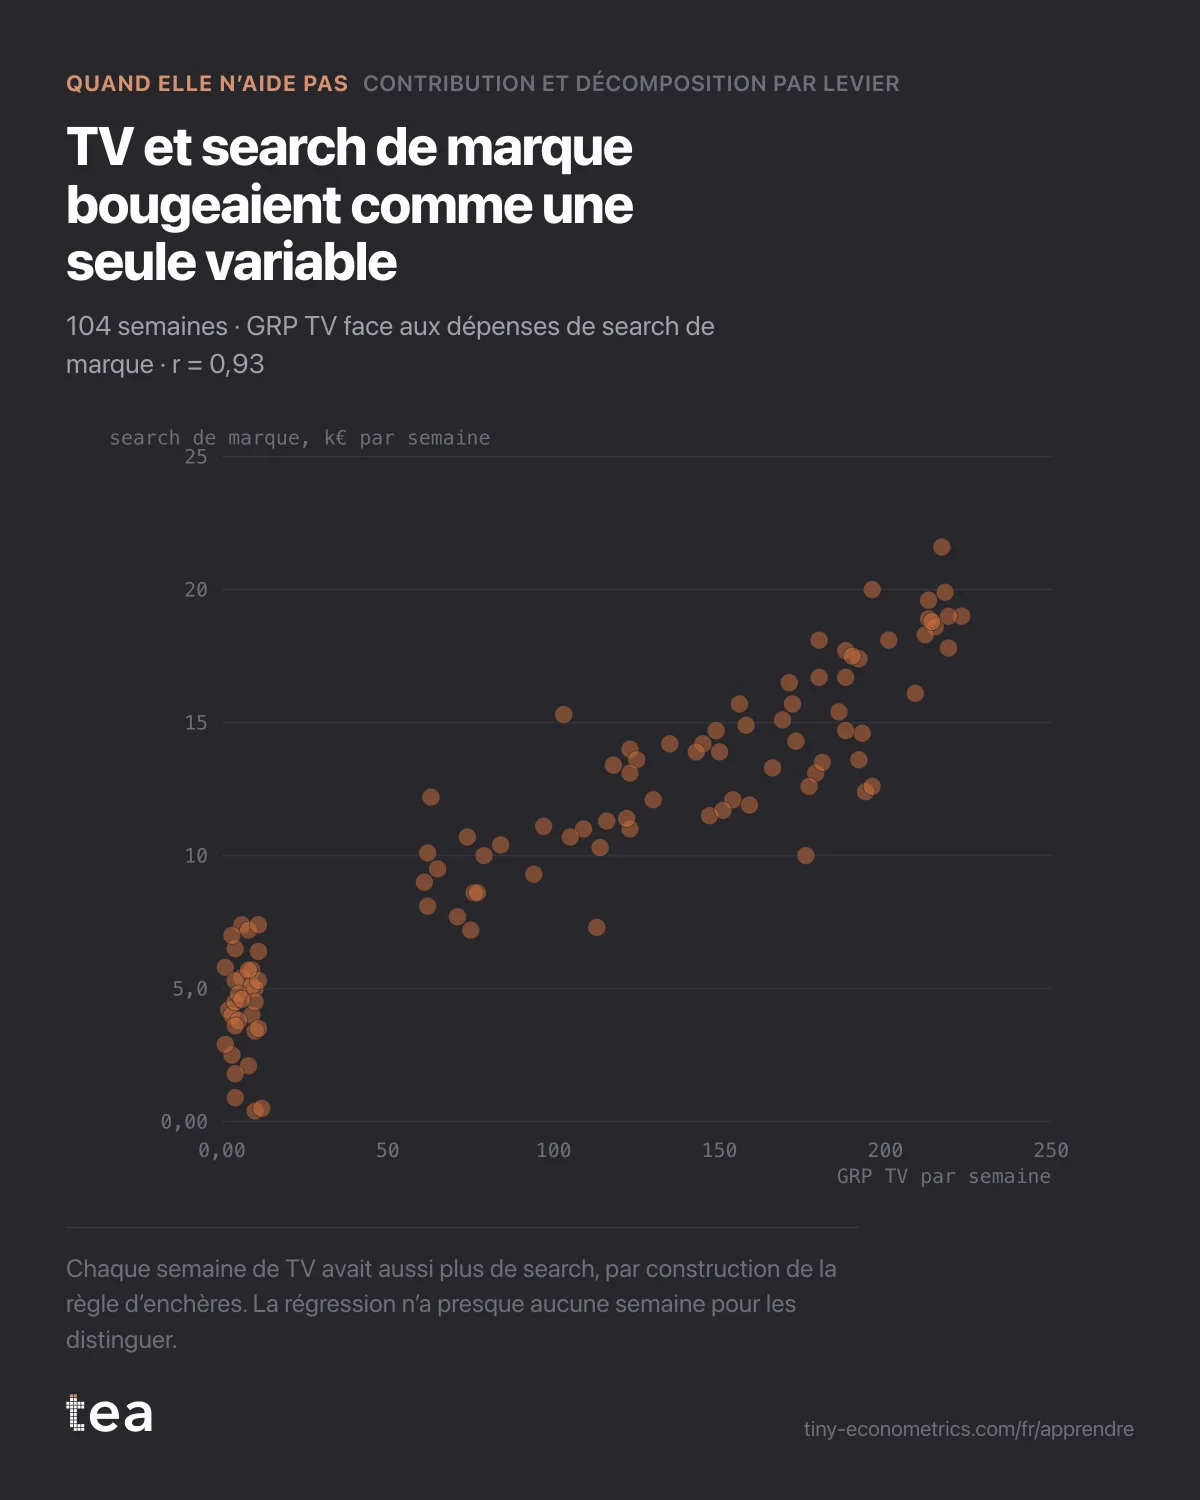
Sur les 104 semaines, les GRP TV et les dépenses en search de marque sont corrélés à r = 0,93. Quand l’un montait, l’autre montait. Quand la TV s’arrêtait, le search baissait. Il n’y a presque aucune semaine où les deux se sont écartés.
Ce que la régression ne pouvait pas faire
Contribution et décomposition par levier ajuste une régression du chiffre d’affaires sur tous les leviers à la fois, avec un adstock sur la TV pour qu’une vague continue d’agir après sa fin. Chaque coefficient est l’effet d’un levier quand les autres restent immobiles.
Cette formule, quand les autres restent immobiles, est tout le problème. Le modèle apprend ce que fait la TV en regardant les semaines où la TV a bougé et le search non. Ce fichier n’en contient presque aucune. Le modèle voit donc que « TV plus search » a fait bouger le chiffre d’affaires, mais il ne voit pas comment répartir le mérite.
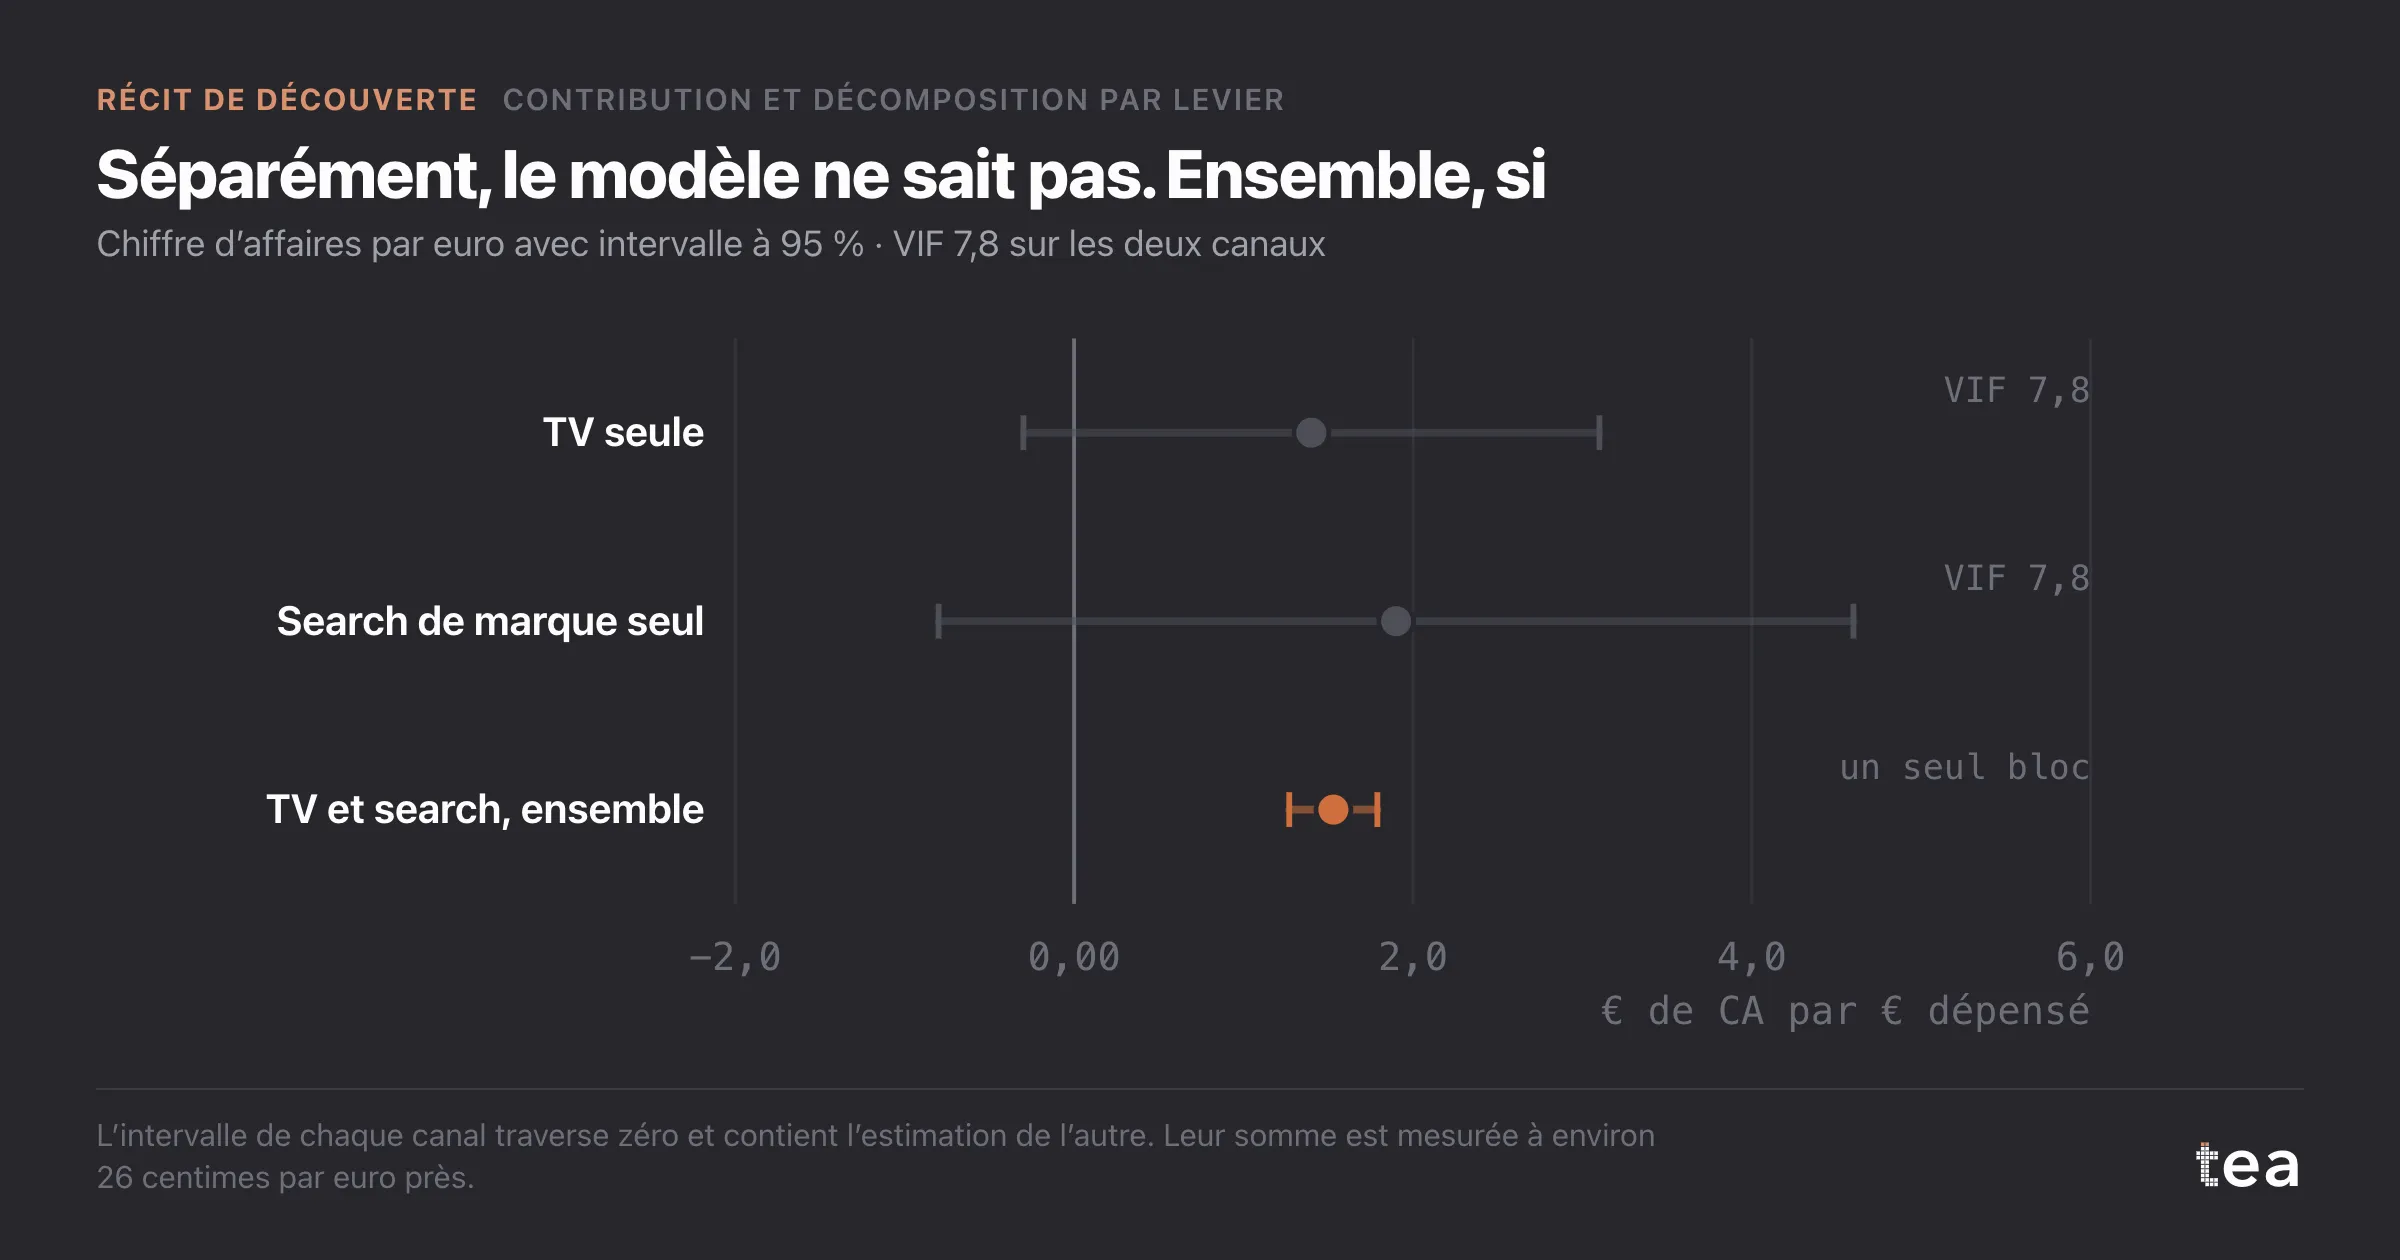
Le diagnostic de ce problème est le facteur d’inflation de la variance (VIF). Sur les deux canaux, il ressortait à 7,8. En clair : l’incertitude sur chaque coefficient est environ 2,8 fois plus large que si les deux canaux avaient bougé indépendamment, parce que la racine carrée de 7,8 vaut 2,8.
Les intervalles le montrent :
- TV : 1,40 € de chiffre d’affaires par euro, intervalle à 95 % de −0,30 € à 3,10 € ;
- search de marque : 1,90 € par euro, intervalle de −0,80 € à 4,60 € ;
- les deux ensemble : 1,53 € par euro, intervalle de 1,27 € à 1,79 €.
L’intervalle de chaque canal traverse zéro et contient l’estimation de l’autre. Leur somme est mesurée à environ 26 centimes près. Les données savent ce que le duo a fait. Elles ne savent pas qui l’a fait.
Ce qui aurait mal tourné en forçant
Les estimations ponctuelles disent que le search rapporte plus que la TV. Lues au pied de la lettre, elles suggèrent de déplacer de l’argent de la TV vers le search. Retirez huit semaines de l’échantillon et réajustez : le classement s’inverse. Deux personnes menant la même analyse sur des périodes légèrement différentes apporteraient à la même réunion des recommandations opposées, chacune avec une régression derrière elle.
Pire, la lecture « le search gagne » est probablement à l’envers quant au mécanisme. Si la TV pousse les gens à chercher la marque, une partie de ce que récolte le search de marque a été créée par la TV. Une baisse de la TV ferait alors aussi baisser le volume du search de marque, et le modèle, entraîné sur un monde où les deux bougeaient toujours ensemble, n’aurait jamais prévenu personne.
Que faire à la place
Regrouper. Présenter la TV et le search de marque comme un seul bloc, 1,53 € par euro avec son intervalle serré, et les planifier ensemble. C’est une réponse moins excitante, et c’est la vraie.
Apporter un a priori issu d’un test. Un test d’exclusion sur le search de marque, avec les enchères sur le nom de la marque suspendues dans quelques régions pendant quatre à six semaines, mesure quelle part de ce trafic serait arrivée de façon organique. Ce chiffre peut ensuite fixer un coefficient, et la régression n’a plus qu’à estimer l’autre.
Casser la corrélation exprès. Pour les deux prochaines vagues, découplez la règle d’enchères : gardez les enchères de marque stables une semaine sur deux, ou laissez une vague tourner avec le search inchangé. Douze à seize semaines de mouvement indépendant suffisent en général pour faire descendre le VIF sous 3.
tea ne mène pas le test. Il lira le fichier qui en sortira.
La leçon
Une régression ne peut séparer que les leviers que les données séparent. Quand deux canaux sont planifiés ensemble, ils sont mesurés ensemble. Si vous voulez savoir ce que fait chacun, l’un des deux doit bouger seul, de temps en temps, exprès.
tea, le produit
Votre fichier, cette question
Quinze analyses sur un CSV de données hebdomadaires, avec les intervalles et les diagnostics sous les yeux, et une phrase claire quand les données ne peuvent pas répondre. Gratuit pendant la bêta, sur invitation.
Demander une place dans la bêta→tea, le produit
Quinze analyses économétriques sur votre propre CSV : Contribution et décomposition par levier, courbes de saturation, élasticités, allocation budgétaire. Les intervalles et les diagnostics sous les yeux, et une phrase claire quand le fichier ne peut pas répondre.
Gratuit pendant la bêta, sur invitation.
Demander une place dans la bêta →Cet article vous a plu ? Lancez l’analyse sur vos propres données.
TEA lance Contribution et décomposition par levier et quatorze autres analyses sur n’importe quel CSV hebdomadaire, en quelques minutes. Gratuit pendant la bêta, sur invitation.
Le Récit de découverte
- Tendance et rupture structurelle : pourquoi une seule droite ment
- Croissance des abonnés : le marketing, ou une pente déjà là
- Pâques et comparaisons annuelles : le trimestre qui n’a pas chuté
- TV et search de marque colinéaires : quand la régression échoue
- Un pic de ventes attribué aux influenceurs, décomposé par levier
- Quel chiffre d’affaires sans marketing ? L’année contrefactuelle (parution le 22 octobre 2026)
- Base vs incrémental après un lancement, sans base dans le fichier (parution le 27 octobre 2026)