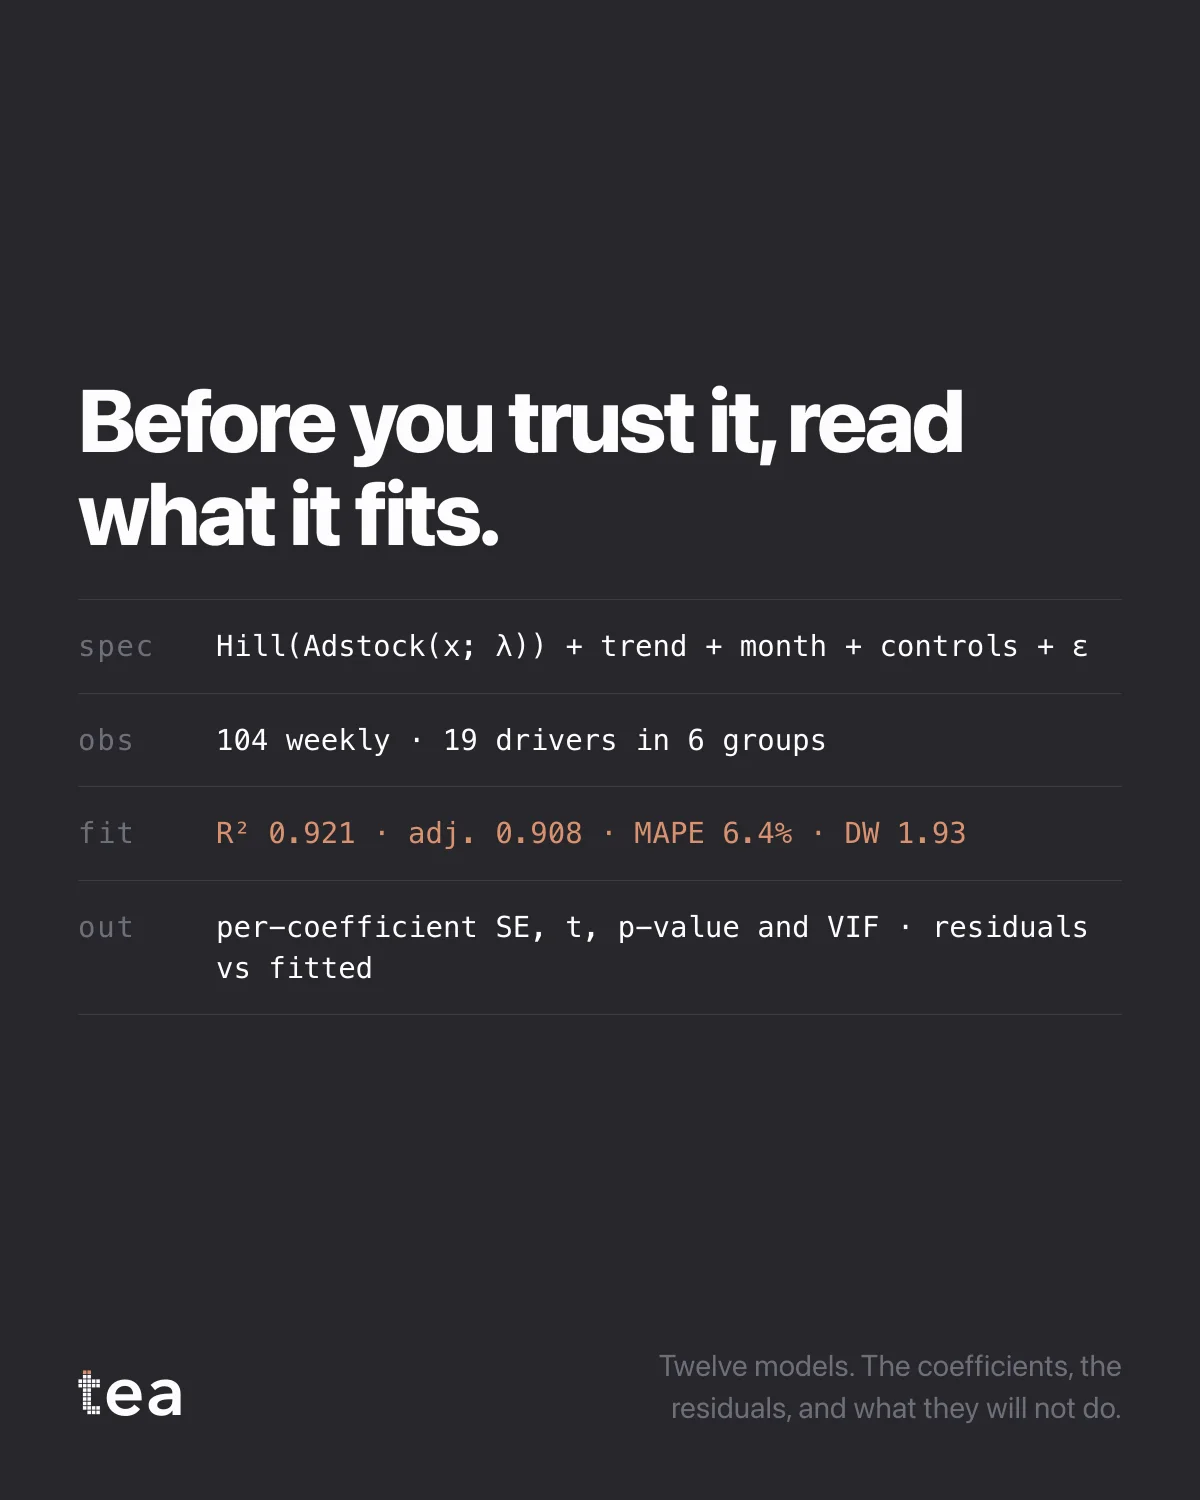
Avant de lui faire confiance, lisez ce qu’il ajuste.
Quatre lignes, et ce sont les quatre qu’un data manager demande avant tout le reste :
La spécification : Hill(Adstock(x; λ)) + tendance + mois + contrôles + ε. Les observations : 104 lignes hebdomadaires, 19 leviers en 6 groupes. L’ajustement : R² 0,921, ajusté 0,908, MAPE 6,4 %, Durbin-Watson 1,93. La sortie : erreur type, t, p-value et VIF pour chaque coefficient, plus les résidus face aux valeurs ajustées.
Rien dans cette liste n’est inhabituel. Ce qui l’est, c’est qu’elle apparaisse tout court, sur le même écran que le résultat, sans que personne ne la demande.
La plupart des outils d’analytics marketing présentent une conclusion et gardent le modèle derrière un ticket de support. Cela fonctionne jusqu’au jour où la personne qui reçoit la conclusion est celle qui possède les données, et là, cela échoue complètement, parce que la première question est toujours la même : qu’avez-vous ajusté, sur quoi, et comment je le vérifie ?
Trois raisons pour lesquelles cela compte, au-delà de la politesse envers les analystes.
Un modèle que l’on ne peut pas inspecter ne peut pas être contesté, et un chiffre qui ne peut pas être contesté ne survit pas à une revue de la direction financière. On l’abandonne discrètement plutôt que d’en débattre.
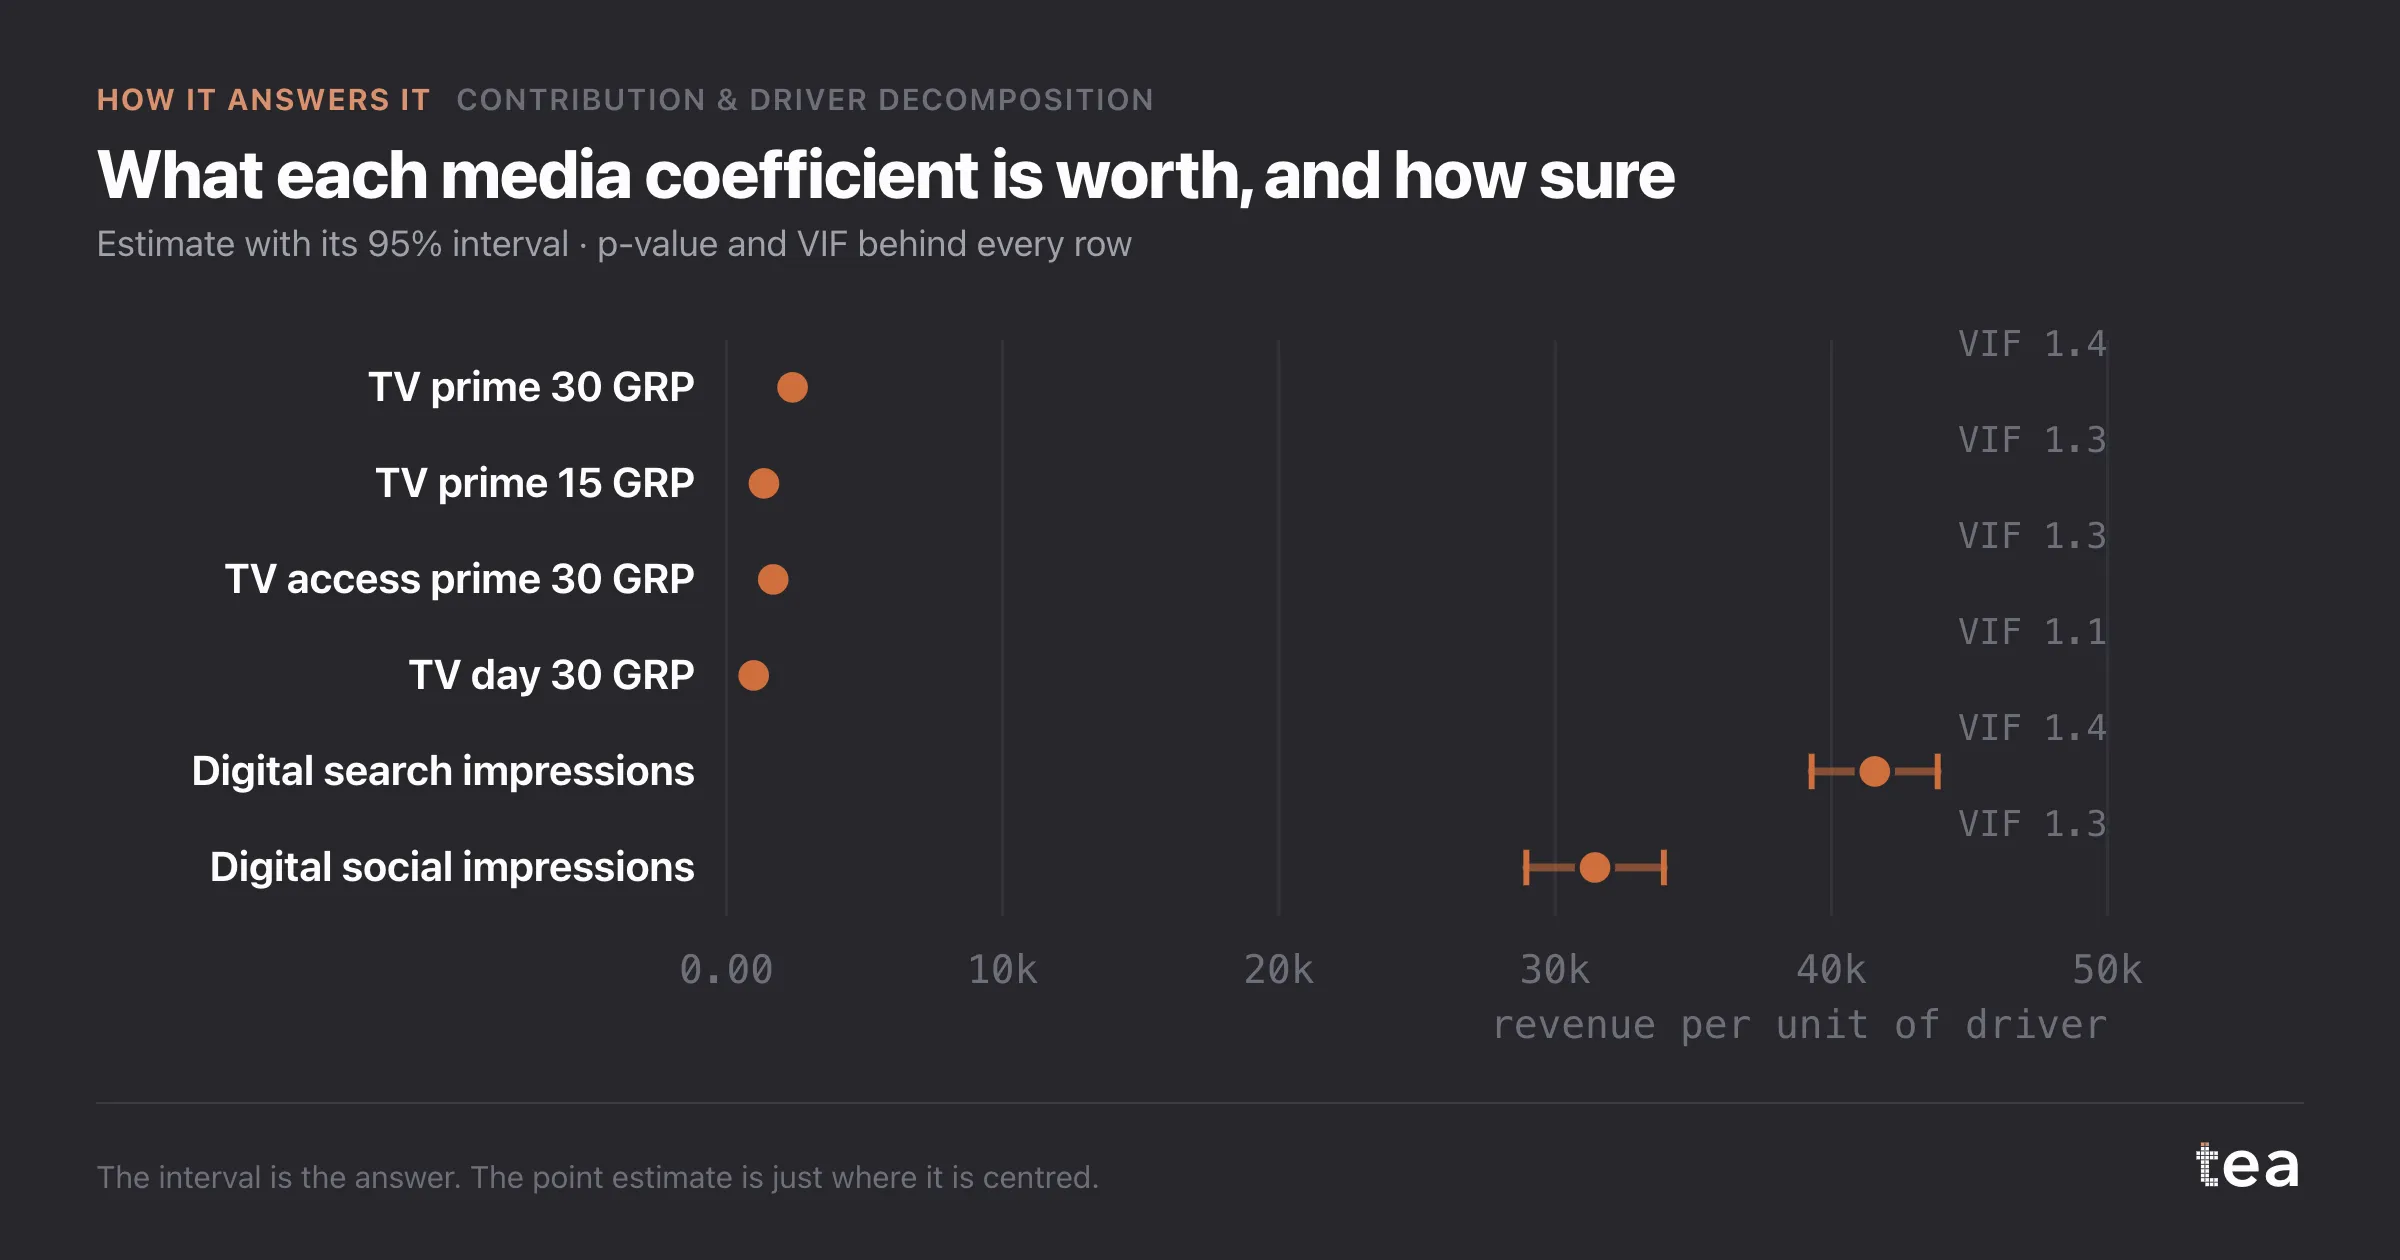
Les diagnostics ne sont pas de la décoration. Un Durbin-Watson à 1,93 dit que les résidus ne sont pas fortement autocorrélés, la condition pour que les intervalles de ces coefficients signifient ce qu’ils prétendent. Sans elle, chaque erreur type de la page est optimiste.
Et la colonne VIF est l’endroit où les modèles média échouent en silence. Des canaux programmés sur les mêmes vagues produisent des coefficients qui échangent leurs places. La contribution totale peut être juste alors qu’aucun levier pris isolément n’est fiable, et seuls les diagnostics de colinéarité vous le diront.
Le principe que nous suivons est simple : tout ce dont un relecteur aurait besoin pour contester le résultat doit figurer sur la même page que le résultat.
Douze modèles, les coefficients, les résidus, et ce qu’ils ne feront pas.
Un mot sur l’endroit où cela fait le plus mal. La personne qui possède les données est généralement celle à qui l’on demande de défendre le modèle devant quelqu’un d’autre, et ce n’est presque jamais elle qui l’a construit. Tout ce qui figure sur cette fiche de quatre lignes existe pour que cette défense soit possible sans un coup de téléphone.
La même fiche rend aussi le refus possible, et c’est plus important encore. Quand l’ajustement est médiocre, que la colinéarité est forte ou que la période est trop courte, un analyste qui a les diagnostics sous les yeux peut dire « pas sur ces données », preuves à l’appui. Sans eux, il ne reste qu’à accepter le chiffre ou à se méfier de l’outil, et les deux finissent mal.
tea, le produit
Votre fichier, cette question
Quinze analyses sur un CSV de données hebdomadaires, avec les intervalles et les diagnostics sous les yeux, et une phrase claire quand les données ne peuvent pas répondre. Gratuit pendant la bêta, sur invitation.
Demander une place dans la bêta→tea, le produit
Quinze analyses économétriques sur votre propre CSV : Contribution et décomposition par levier, courbes de saturation, élasticités, allocation budgétaire. Les intervalles et les diagnostics sous les yeux, et une phrase claire quand le fichier ne peut pas répondre.
Gratuit pendant la bêta, sur invitation.
Demander une place dans la bêta →Cet article vous a plu ? Lancez l’analyse sur vos propres données.
TEA lance Contribution et décomposition par levier et quatorze autres analyses sur n’importe quel CSV hebdomadaire, en quelques minutes. Gratuit pendant la bêta, sur invitation.