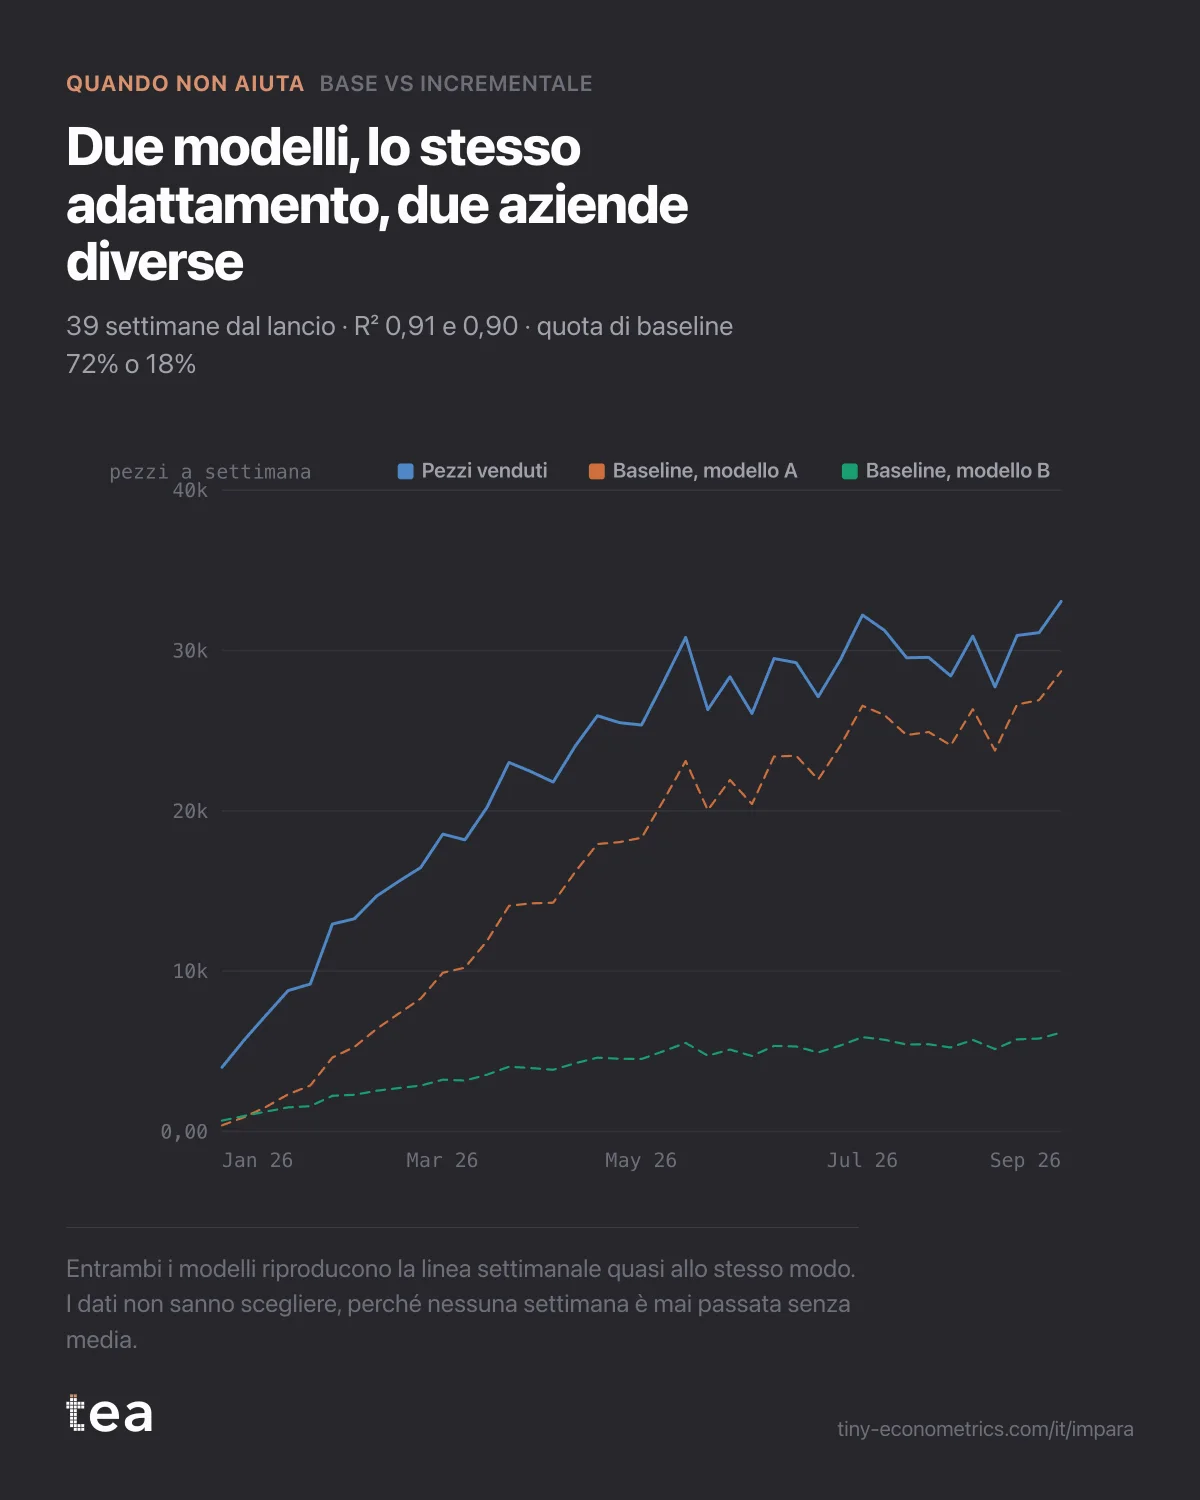
Bevanda proteica vegetale in Germania, 39 settimane dal lancio, media ogni settimana: il consiglio di amministrazione chiede quanto si venderebbe senza pubblicità.
Un caso composito, costruito sul tipo di file che vediamo quasi ogni settimana. Una bevanda proteica vegetale lanciata in Germania il 5 gennaio 2026, venduta nella grande distribuzione e nelle drogherie, con un budget di lancio partito dalla prima settimana.
Dopo nove mesi, il consiglio di amministrazione ha fatto la domanda che chiude la Storia di esplorazione: «Quanto di quello che vendiamo lo venderemmo senza pubblicità? Dobbiamo sapere su cosa si regge il marchio prima di fissare il budget dell’anno prossimo.»
È una buona domanda. Questo file non sa rispondere.
Com’era fatto il file
39 righe settimanali, da gennaio a settembre 2026. Pezzi venduti, in crescita da circa 4.000 nella prima settimana a circa 33.000 nell’ultima, 892.000 in tutto. Spesa media fra TV, social e retail media, fra €40.000 e €70.000 ogni singola settimana. Numero di punti vendita, da circa 1.200 a gennaio a 4.800 in estate, man mano che arrivavano i listing. Prezzo medio, quasi costante.
Mancava proprio la cosa su cui verte la domanda. Non c’è una settimana senza media. Non c’è una settimana con pochi media. La spesa più bassa del file è €40.000.
Perché la divisione non si può fare
Base vs incrementale costruisce la baseline mettendo a zero i media in un modello stimato e leggendo cosa resta. Nel caso del retailer aveva funzionato, perché il file aveva periodi di buio e settimane vicine allo zero. Lo zero del modello era vicino a qualcosa che aveva visto.
Qui lo zero del modello sta a €40.000 dall’osservazione più vicina. Qualunque cosa dica su un mondo senza media è un’estrapolazione pura da una fascia fra €40.000 e €70.000, senza niente a cui ancorarla.
E non è solo la distanza. Tre cose sono cresciute insieme nelle stesse 39 settimane: il numero di punti vendita, l’awareness che ogni marchio nuovo costruisce man mano che la gente lo incontra, e il peso cumulato dei media che l’adstock porta avanti. Ognuna delle tre può spiegare una linea di vendite in salita. È lo stesso problema del caso TV e search, con una complicazione in più: uno dei driver collineari è il tempo stesso.
Così abbiamo stimato tre modelli difendibili, per verificare quanto la risposta dipenda dalla scelta:
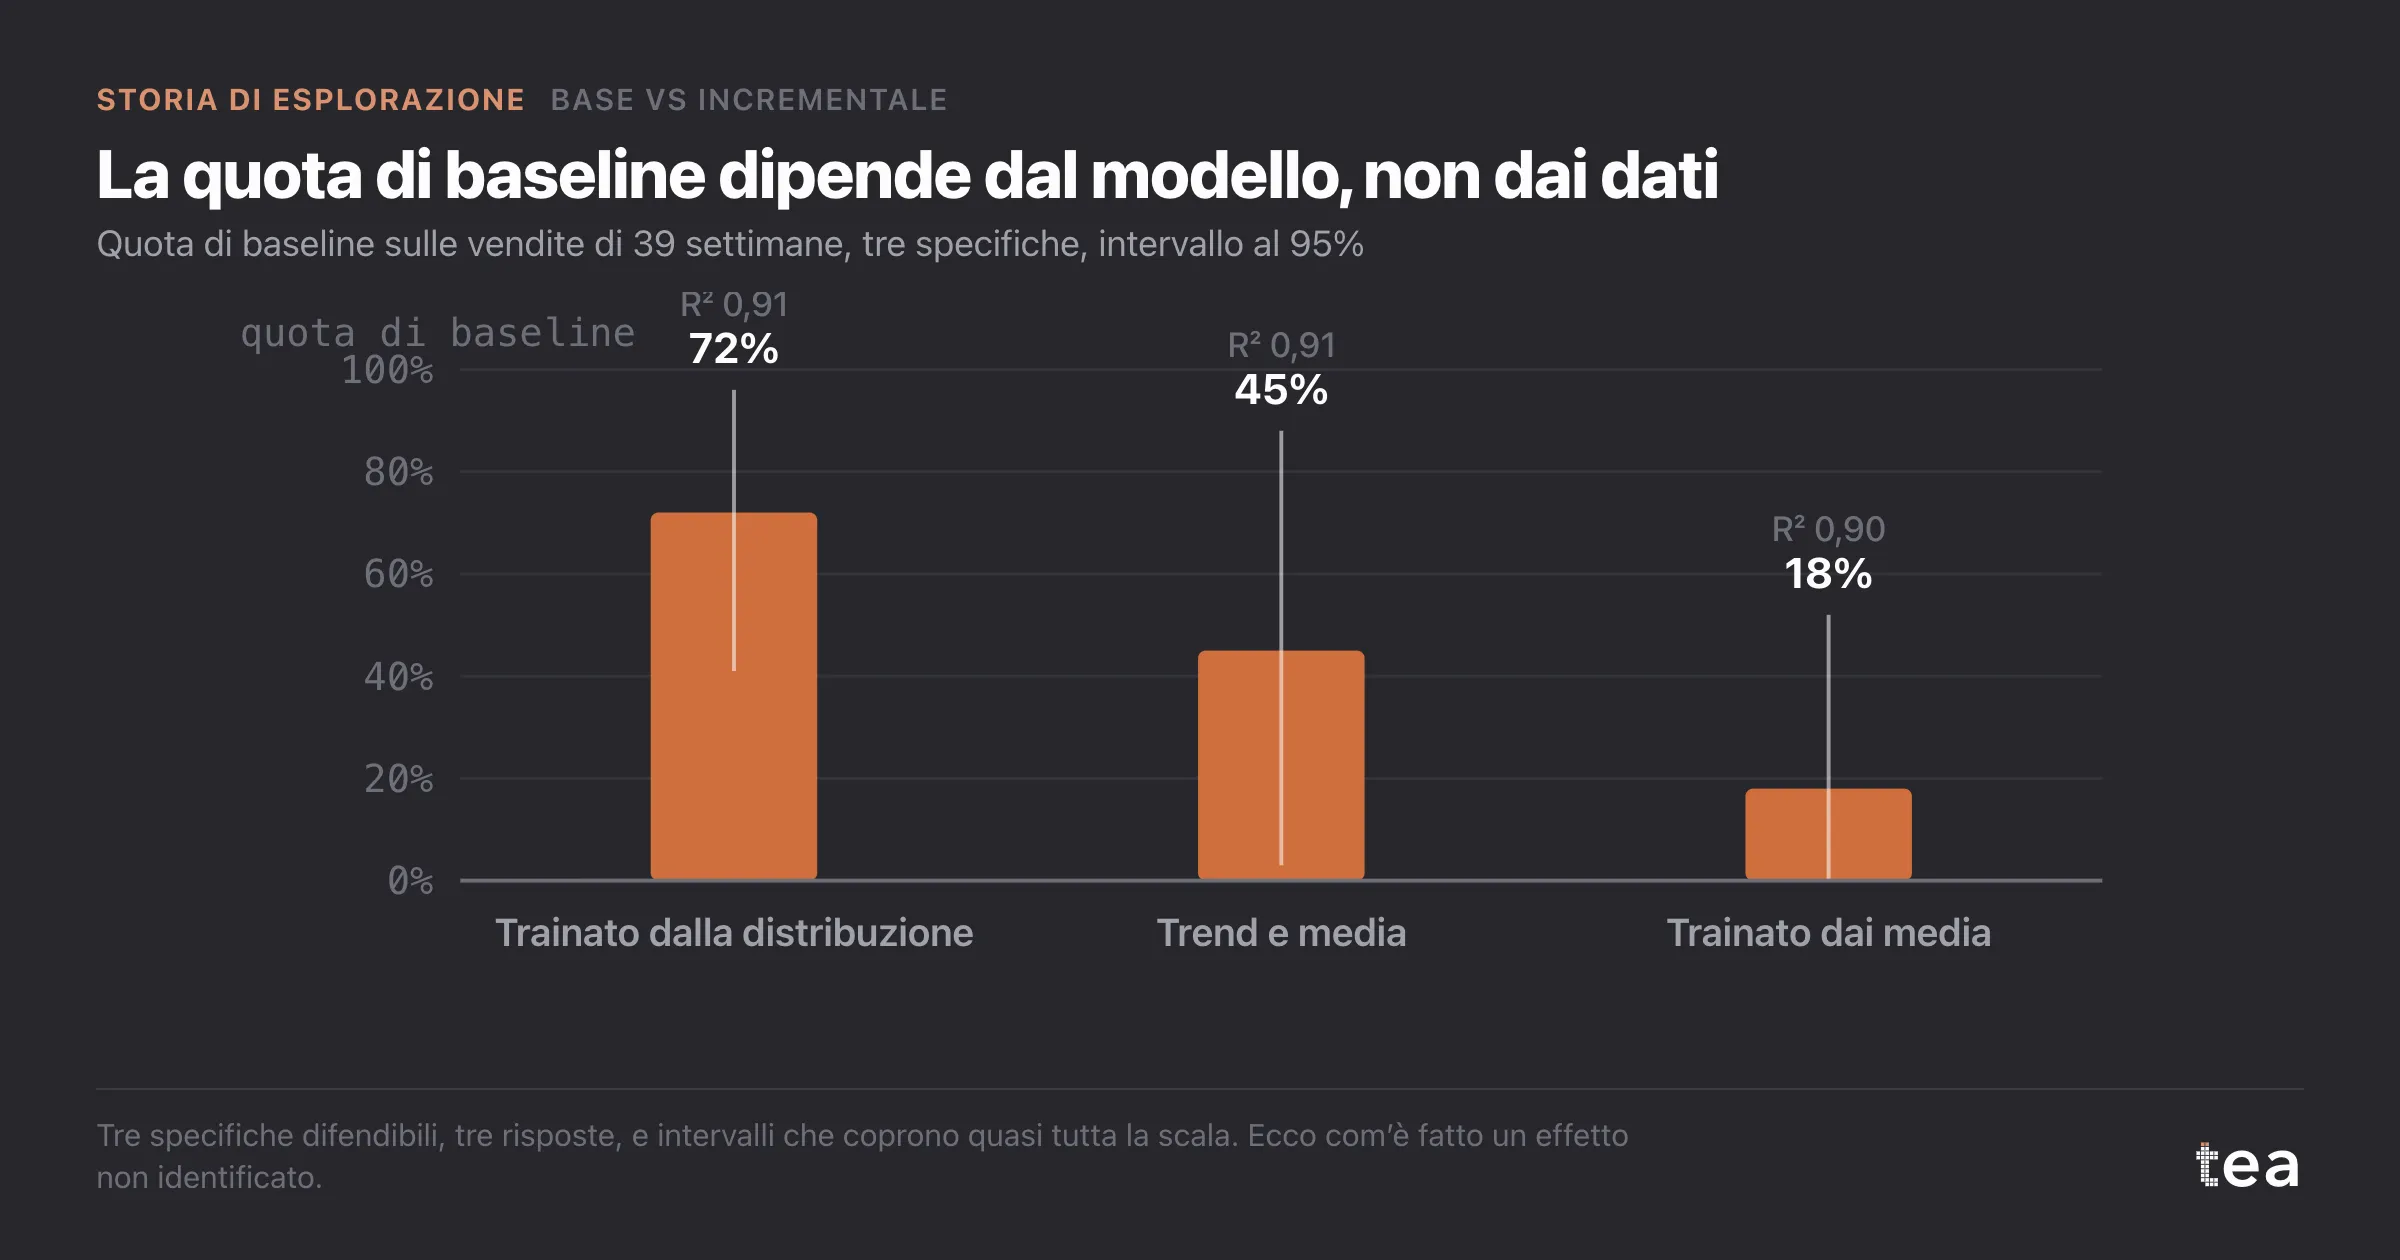
- trainato dalla distribuzione, dove il numero di negozi porta la crescita e i media si aggiungono sopra: R² 0,91, quota di baseline 72%, intervallo dal 41% al 96%;
- trend e media, con una curva di lancio per l’awareness: R² 0,91, quota di baseline 45%, intervallo dal 3% all’88%;
- trainato dai media, dove i media cumulati costruiscono il marchio: R² 0,90, quota di baseline 18%, intervallo dallo 0% al 52%.
Tutti e tre riproducono la linea settimanale quasi allo stesso modo. Nessuna diagnostica ne preferisce uno. Ai dati va bene allo stesso modo un marchio che si regge soprattutto sui listing e uno che si regge soprattutto sulla pubblicità.
Ecco cosa vuol dire «non identificato». Non è una stima debole che un po’ più di cura renderebbe precisa. È una domanda per cui il file non contiene l’informazione.
Cosa sarebbe andato storto forzando
Uno qualsiasi dei tre numeri si poteva stampare con un grafico e una virgola. Il consiglio avrebbe poi scelto, senza saperlo, fra «dimezziamo i media, il lavoro lo fanno gli scaffali» e «continuiamo a spendere, il marchio è la pubblicità». Sono due strategie ragionevoli. Nessuna delle due va scelta in base a quale regressione qualcuno ha lanciato per prima.
Cosa fare invece
La baseline va creata, perché non è mai stata osservata.
Regioni di controllo. Spegnere i media in due delle aree Nielsen tedesche per otto-dieci settimane, con un numero di punti vendita allineato al resto del paese, e tenerli accesi altrove. Lo scarto fra i due gruppi è l’effetto incrementale, misurato invece che modellato. Con una colonna regione nel file, un modello geo può poi leggere il risultato.
Scaglionare il prossimo lancio. Austria e Svizzera sono nel piano per il 2027. Mettere il prodotto a scaffale sei-otto settimane prima che partano i media. Quelle settimane sono la baseline di quel mercato, e dicono parecchio anche su questo.
Variare la spesa apposta. Anche senza un vero gruppo di controllo, qualche settimana bassa deliberata, a €10.000 invece di €40.000, dà al modello un’ancora più in basso.
Aspettare che la distribuzione si assesti. Quando il numero di negozi smette di crescere, uno dei tre driver smette di muoversi, e gli altri due diventano più facili da separare.
La lezione
Una baseline non è un numero nascosto nei tuoi dati. È un mondo che i tuoi dati devono aver visitato. Se il marketing è acceso dal primo giorno, quel mondo non l’ha visto nessuno, e il passo onesto successivo è organizzare una visita.
tea, il prodotto
Il tuo file, questa domanda
Quindici analisi su un CSV di dati settimanali, con intervalli e diagnostica in vista, e una frase chiara quando i dati non possono rispondere. Gratis durante la beta, su invito.
Chiedi un posto nella beta→tea, il prodotto
Quindici analisi econometriche sul tuo CSV: Base vs incrementale, curve di saturazione, elasticità, allocazione del budget. Intervalli e diagnostica in vista, e una frase chiara quando il file non può rispondere.
Gratis durante la beta, su invito.
Chiedi un posto nella beta →Ti è piaciuto? Eseguilo sui tuoi dati.
tea esegue Base vs incrementale e altre quattordici analisi su qualsiasi CSV settimanale, in pochi minuti. Gratis durante la beta, su invito.
La Storia di esplorazione
- Trend con un break strutturale: perché una sola retta mente
- Abbonati portati dal marketing, o una pendenza che c’era già
- Pasqua, confronti anno su anno e il trimestre che non è crollato
- Collinearità fra TV e search di brand: quando la regressione cede
- Picco di vendite attribuito agli influencer, scomposto per driver
- Quanto fattureresti senza marketing? L’anno controfattuale
- Base vs incrementale dopo un lancio, senza una base nei dati