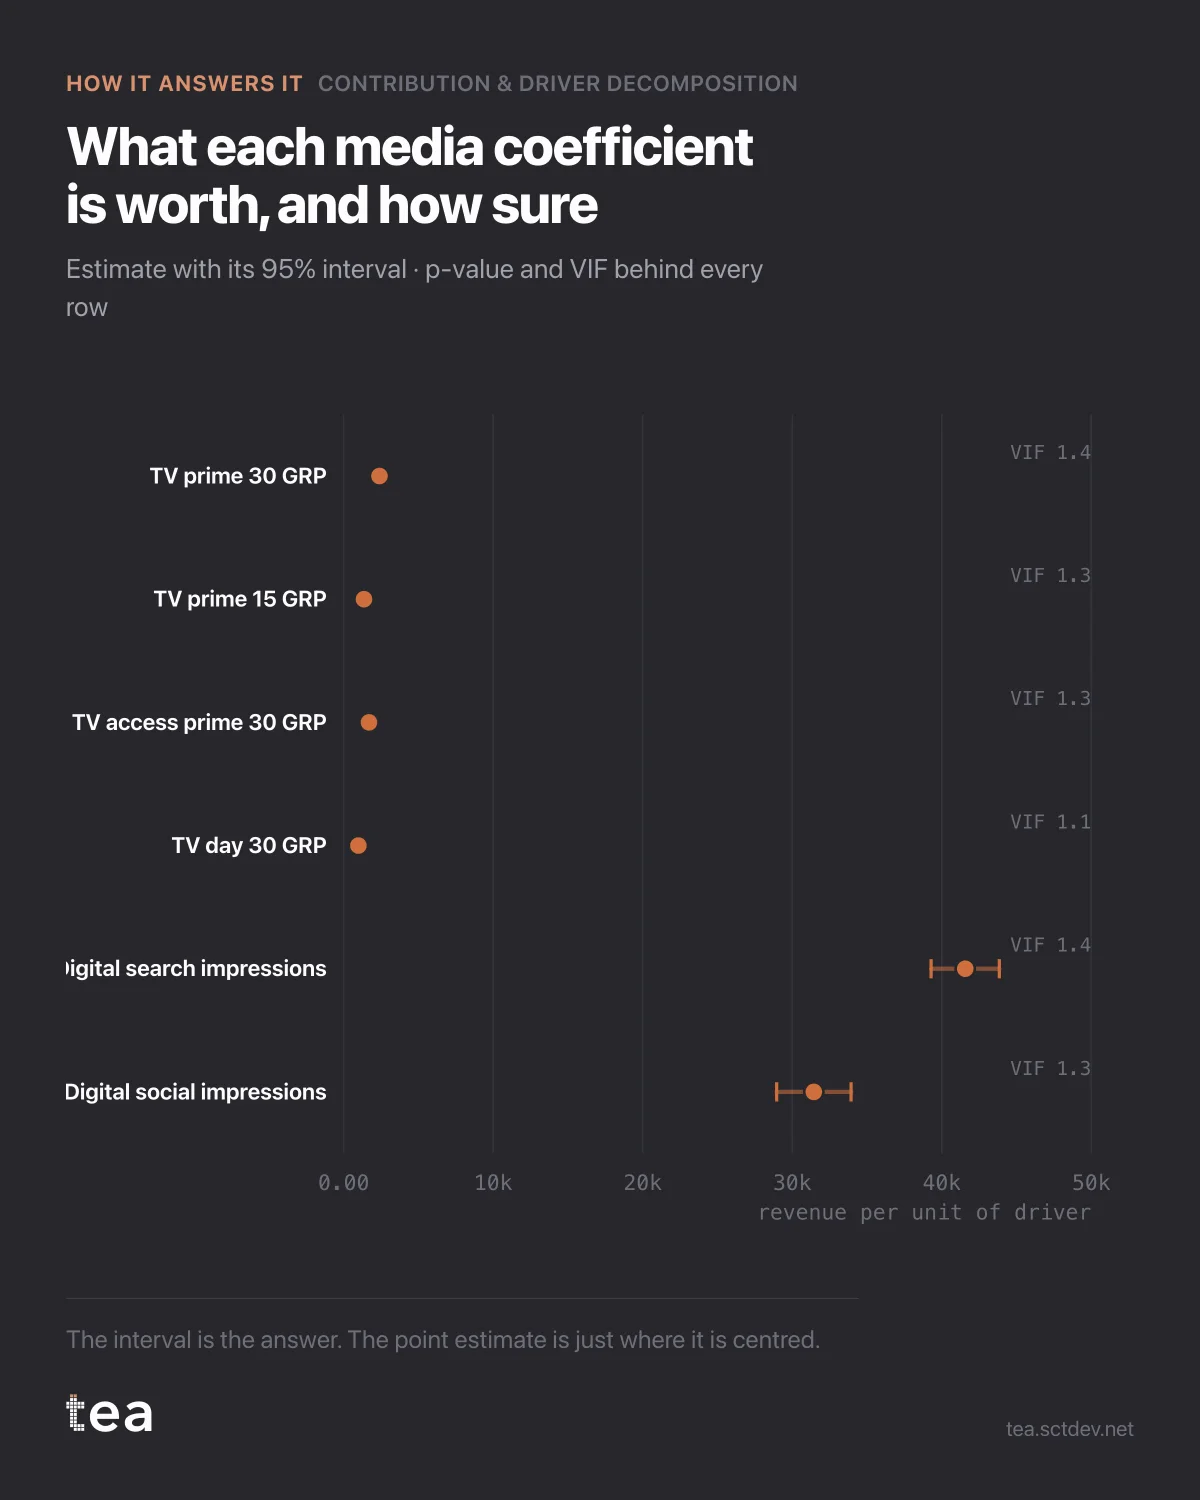
Un grafico dei contributi è un insieme di stime puntuali. Questo è il grafico che ti dice se crederci.
Ogni riga è un coefficiente media con il suo intervallo al 95%: quanto vale un’unità in più di quel driver, e quanto i dati sono disposti a impegnarsi su quel numero.
La lettura è meccanica. Un intervallo ben lontano dallo zero è un driver su cui puoi pianificare. Un intervallo a cavallo dello zero è un driver il cui effetto i dati non riescono a distinguere dal nulla, qualunque fosse l’aspetto della barra nel grafico dei contributi.
Qui ogni intervallo dei media sta lontano dallo zero, ed è l’aspetto di un file pulito con una vera variazione nella pianificazione. È il caso buono, e vale la pena sapere che cosa lo rende possibile invece di darlo per normale.
Quattro cose dietro questi intervalli:
L’errore standard. TV prime 30 esce a 2.396 di ricavi per GRP con un errore standard di 58. È una stima stretta. Digital search, a 41.570 con un errore standard di 1.165, è stretta anche lei, in proporzione. Le stime puntuali non sono più affidabili dei loro errori.
Il p-value, riportato per ogni coefficiente e non per il modello nel suo insieme. Un modello con un R² eccellente può contenere driver che non contribuiscono niente di misurabile, e l’adattamento complessivo non ti dirà mai quali.
Il VIF, che è quello silenzioso. Misura quanto l’errore di ogni driver viene gonfiato dalla sua correlazione con gli altri. Qui il massimo è 1,9, un valore tranquillo. Sopra 5 i coefficienti cominciano a scambiarsi di posto, e sopra 10 i singoli numeri non sono separabili anche se il totale va bene. È la differenza tra un modello che funziona e un modello di cui puoi citare le parti.
E il comportamento dei residui. Un Durbin-Watson di 2,35 su 103 settimane dice che gli avanzi non sono fortemente autocorrelati, che è la condizione perché questi intervalli significhino quello che dicono.
R² è 0,995 e il MAPE è 0,52%. Sono numeri splendidi e da soli non dimostrano quasi niente: un modello può riprodurre lo storico benissimo e non essere comunque in grado di attribuirlo. È nella tabella dei coefficienti che si decide l’attribuzione.
L’abitudine da costruire è piccola. Quando qualcuno ti mostra un grafico dei contributi, chiedi questo. Se non esiste, il grafico dei contributi è un insieme di numeri con barre d’errore sconosciute, e l’altezza di una barra non ti dice niente sul fatto che il driver dietro sia reale.
È anche il modo più rapido per riconoscere un modello sovraspecificato per fare bella figura. Venti driver, un R² splendido e metà degli intervalli che attraversano lo zero non sono un modello solido con qualche parte debole. Sono un modello che ha stimato il rumore e distribuisce il merito a caso.
Il grafico è l’output reale di Scomposizione dei contributi e dei driver in TEA. L’intervallo, il p-value e il VIF arrivano con ogni driver.
tea, il prodotto
Il tuo file, questa domanda
Quindici analisi su un CSV di dati settimanali, con intervalli e diagnostica in vista, e una frase chiara quando i dati non possono rispondere. Gratis durante la beta, su invito.
Chiedi un posto nella beta→tea, il prodotto
Quindici analisi econometriche sul tuo CSV: Scomposizione dei contributi e dei driver, curve di saturazione, elasticità, allocazione del budget. Intervalli e diagnostica in vista, e una frase chiara quando il file non può rispondere.
Gratis durante la beta, su invito.
Chiedi un posto nella beta →Ti è piaciuto? Eseguilo sui tuoi dati.
tea esegue Scomposizione dei contributi e dei driver e altre quattordici analisi su qualsiasi CSV settimanale, in pochi minuti. Gratis durante la beta, su invito.