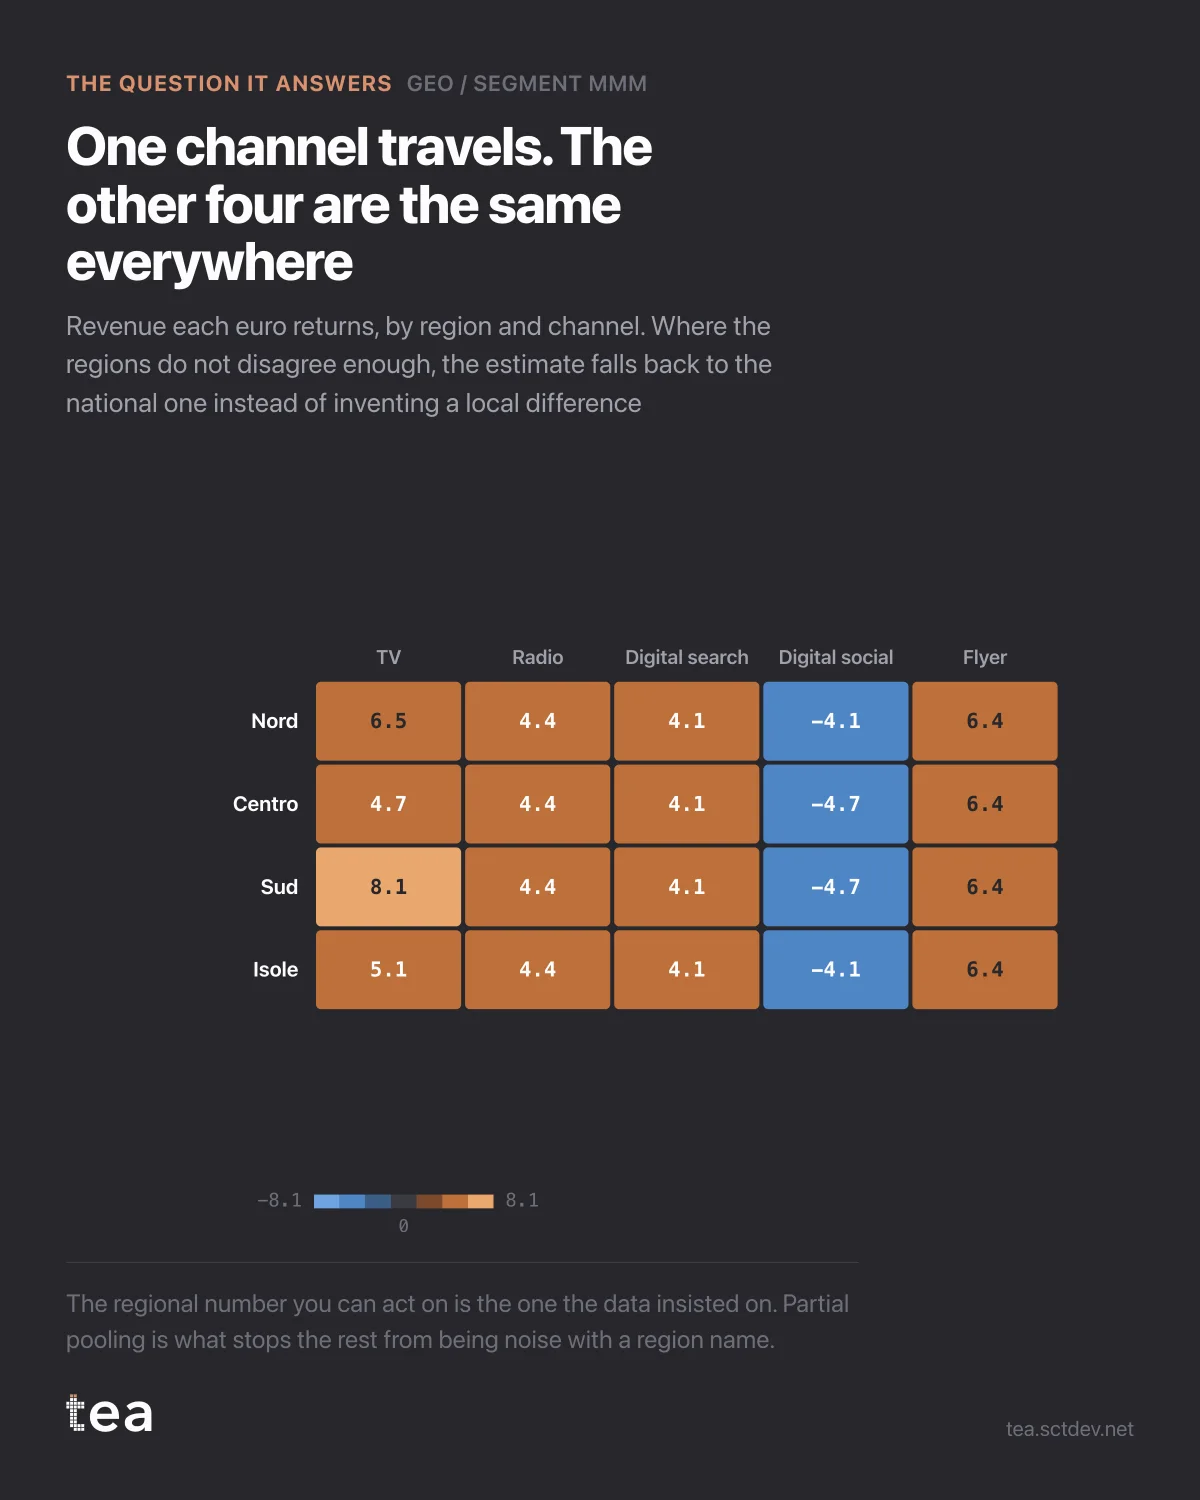
Cuatro regiones, cinco canales, y la cuadrícula muestra lo que devuelve cada euro en cada celda.
Recorre las filas y la mayoría de los números se repiten. La radio devuelve 4,4 en todas partes. La búsqueda digital, 4,1 en todas partes. El folleto, 6,4 en todas partes. Solo cambia la TV: 8,1 en el sur, 4,7 en el centro, con el norte y las islas entre medias.
No es que el modelo sea perezoso. Es el agrupamiento parcial haciendo exactamente aquello para lo que existe.
Este es el problema que resuelve. Si ajustas cada región por separado, obtienes cuatro estimaciones independientes, cada una construida sobre una cuarta parte de los datos, cada una con un intervalo amplio y cada una libre de irse a donde la lleve su propio ruido. Luego alguien construye un plan regional sobre una diferencia que nunca fue real. Si las ajustas todas juntas, obtienes un único número nacional que esconde cualquier diferencia local genuina.
El agrupamiento parcial está entre las dos cosas. La estimación de cada región se acerca a la media nacional, y cuánto se acerca depende de cuánta evidencia aporta esa región y de cuánto discrepan de verdad las regiones entre sí. Cuando un canal se comporta realmente de forma distinta según la región, las estimaciones se separan. Cuando la diferencia aparente está dentro de lo que produciría el ruido, vuelven a juntarse en el número nacional.
Así que esta cuadrícula es un mapa de dónde existe evidencia local. La TV la tiene. Los otros cuatro canales no, en este archivo y con esta longitud de histórico.
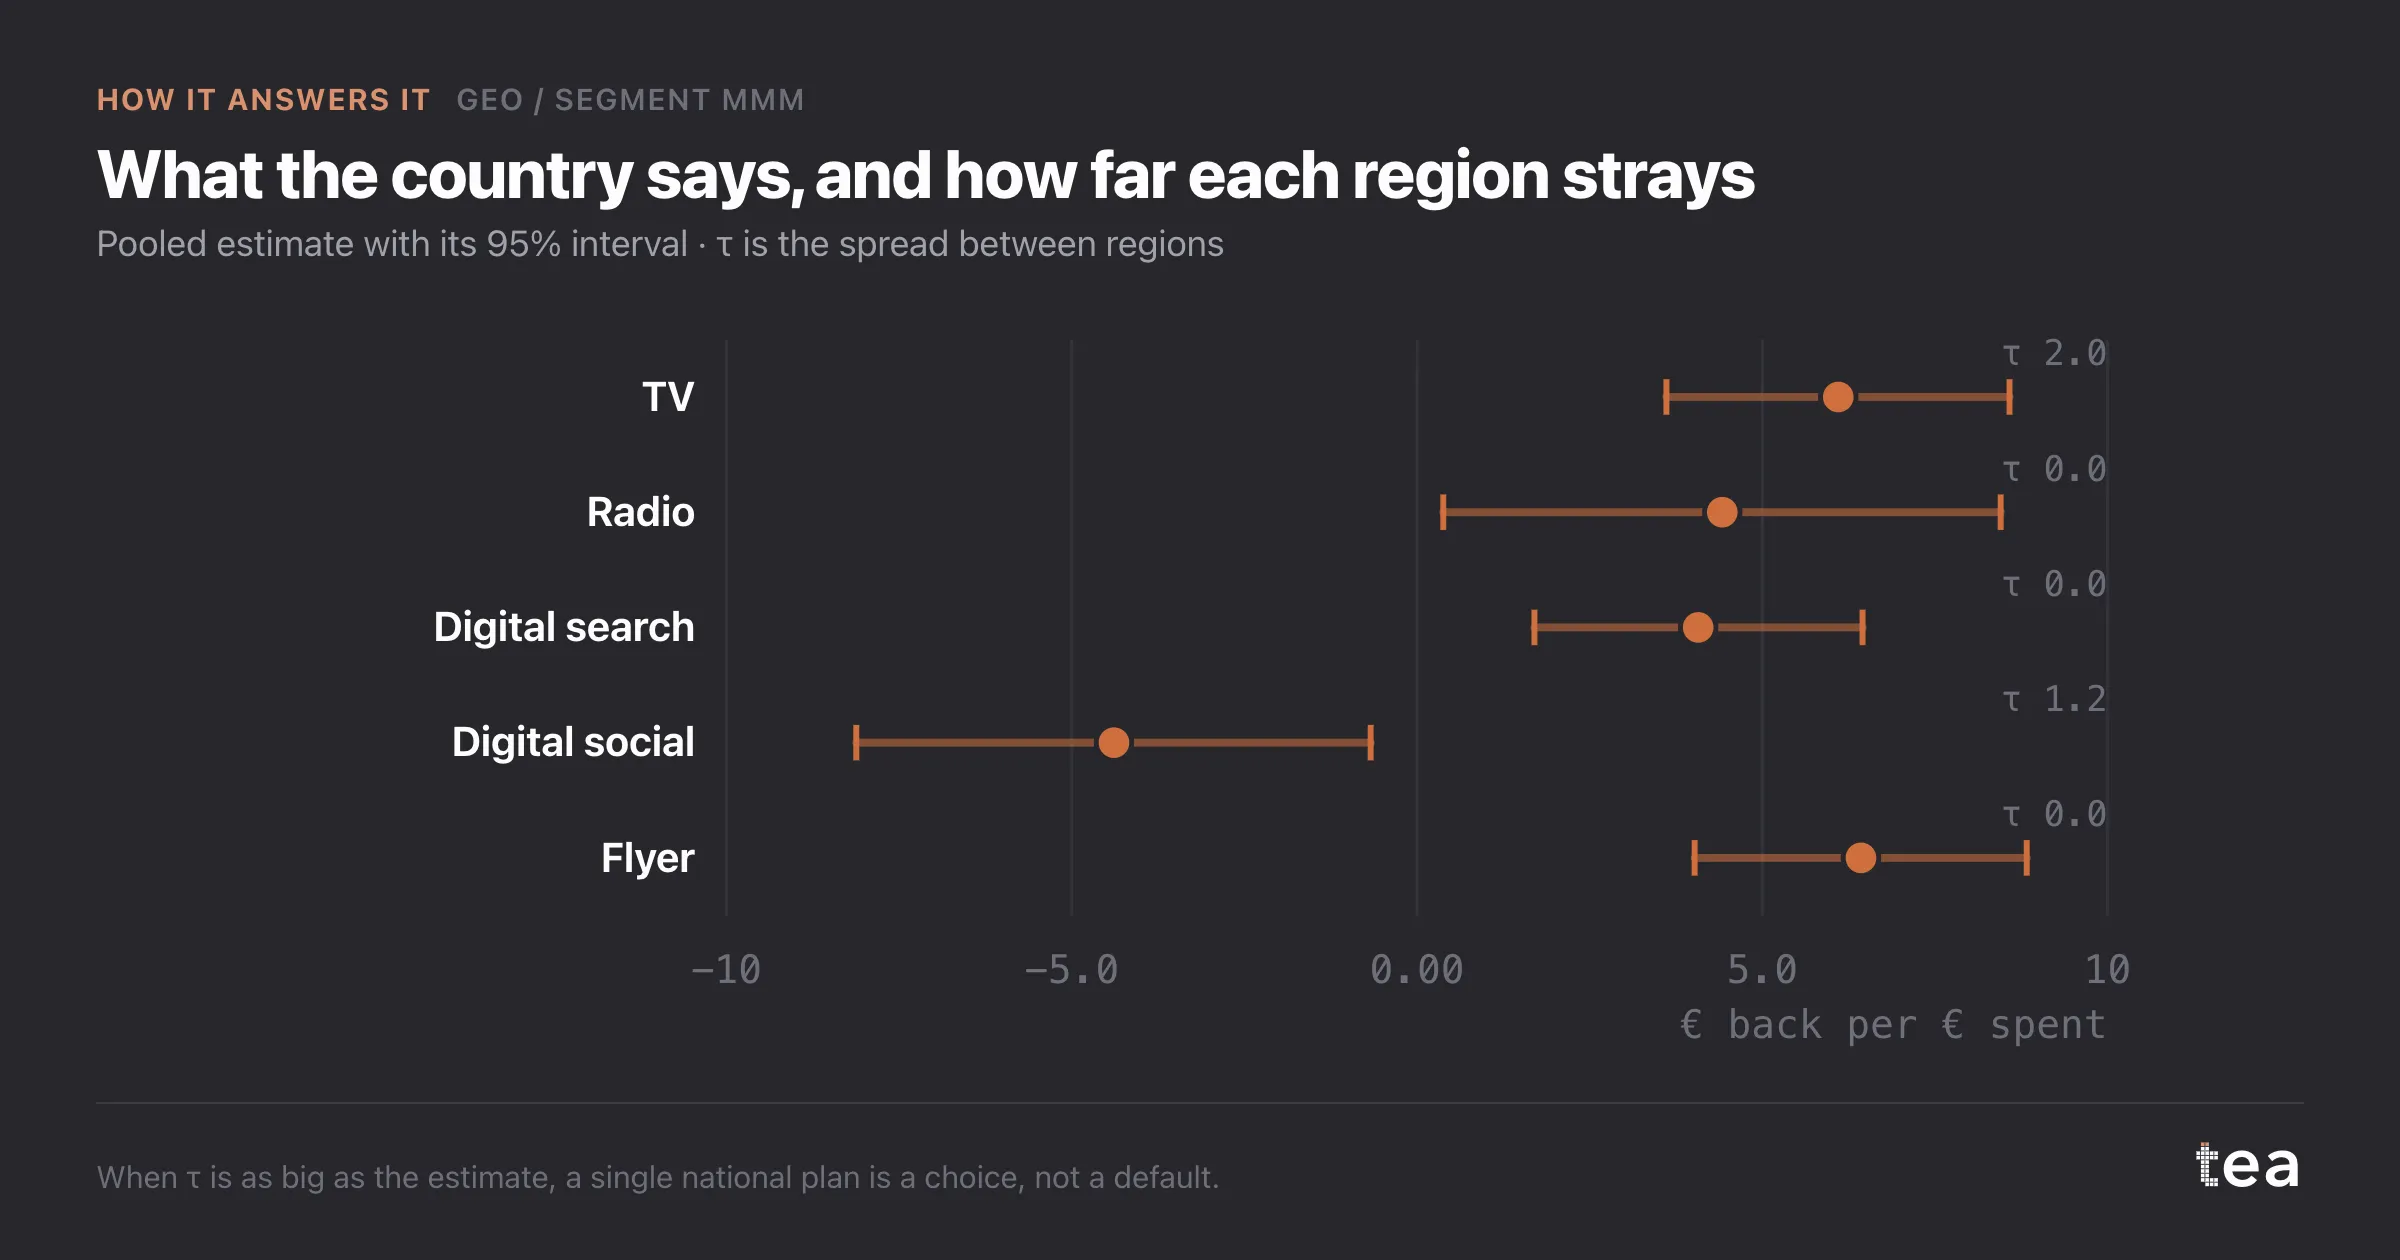
Lo que eso significa para un plan es directo. La TV la compras por región, porque la diferencia es real y vale 3,4 puntos de retorno entre la mejor y la peor. El resto lo compras a nivel nacional, porque las diferencias regionales sobre las que estarías planificando no se distinguen del ruido.
Es un plan mucho más corto y mucho más seguro que el que habrían dado cuatro regresiones separadas.
El requisito práctico es una columna. El mismo archivo semanal que usarías para un modelo nacional, con una columna de región, ciudad, grupo de tiendas o segmento añadida, y periodos suficientes por segmento para que cada uno tenga algo que decir. Cuatro regiones durante 104 semanas son 416 filas, que va de sobra.
Lo que te devuelve es una decisión que la mayoría de los equipos toma a ojo cada año: cuánto de local debe ser el plan. El instinto suele responder con el organigrama, porque existe un equipo regional, o con la petición que más suena. La varianza de los datos responde de otra manera y más barata.
Y cuando la cuadrícula sale del todo uniforme, eso también es un resultado. Significa que el plan nacional es el plan correcto, y que puedes dejar de gastar tiempo de dirección en excepciones regionales que el mercado no respalda.
El gráfico es el resultado real de MMM geográfico / por segmento en TEA, ejecutado sobre un archivo de ejemplo que cualquiera puede descargar.
tea, el producto
Tu archivo, esta pregunta
Quince análisis sobre un CSV de datos semanales, con los intervalos y los diagnósticos a la vista, y una frase clara cuando los datos no pueden responder. Gratis durante la beta, por invitación.
Pide una plaza en la beta→tea, el producto
Quince análisis econométricos con tu propio CSV: MMM geográfico / por segmento, curvas de saturación, elasticidades, asignación del presupuesto. Intervalos y diagnósticos a la vista, y una frase clara cuando el archivo no puede responder.
Gratis durante la beta, por invitación.
Pide una plaza en la beta →¿Te ha servido? Ejecútalo con tus propios datos.
tea ejecuta MMM geográfico / por segmento y otros catorce análisis con cualquier CSV semanal, en minutos. Gratis durante la beta, por invitación.