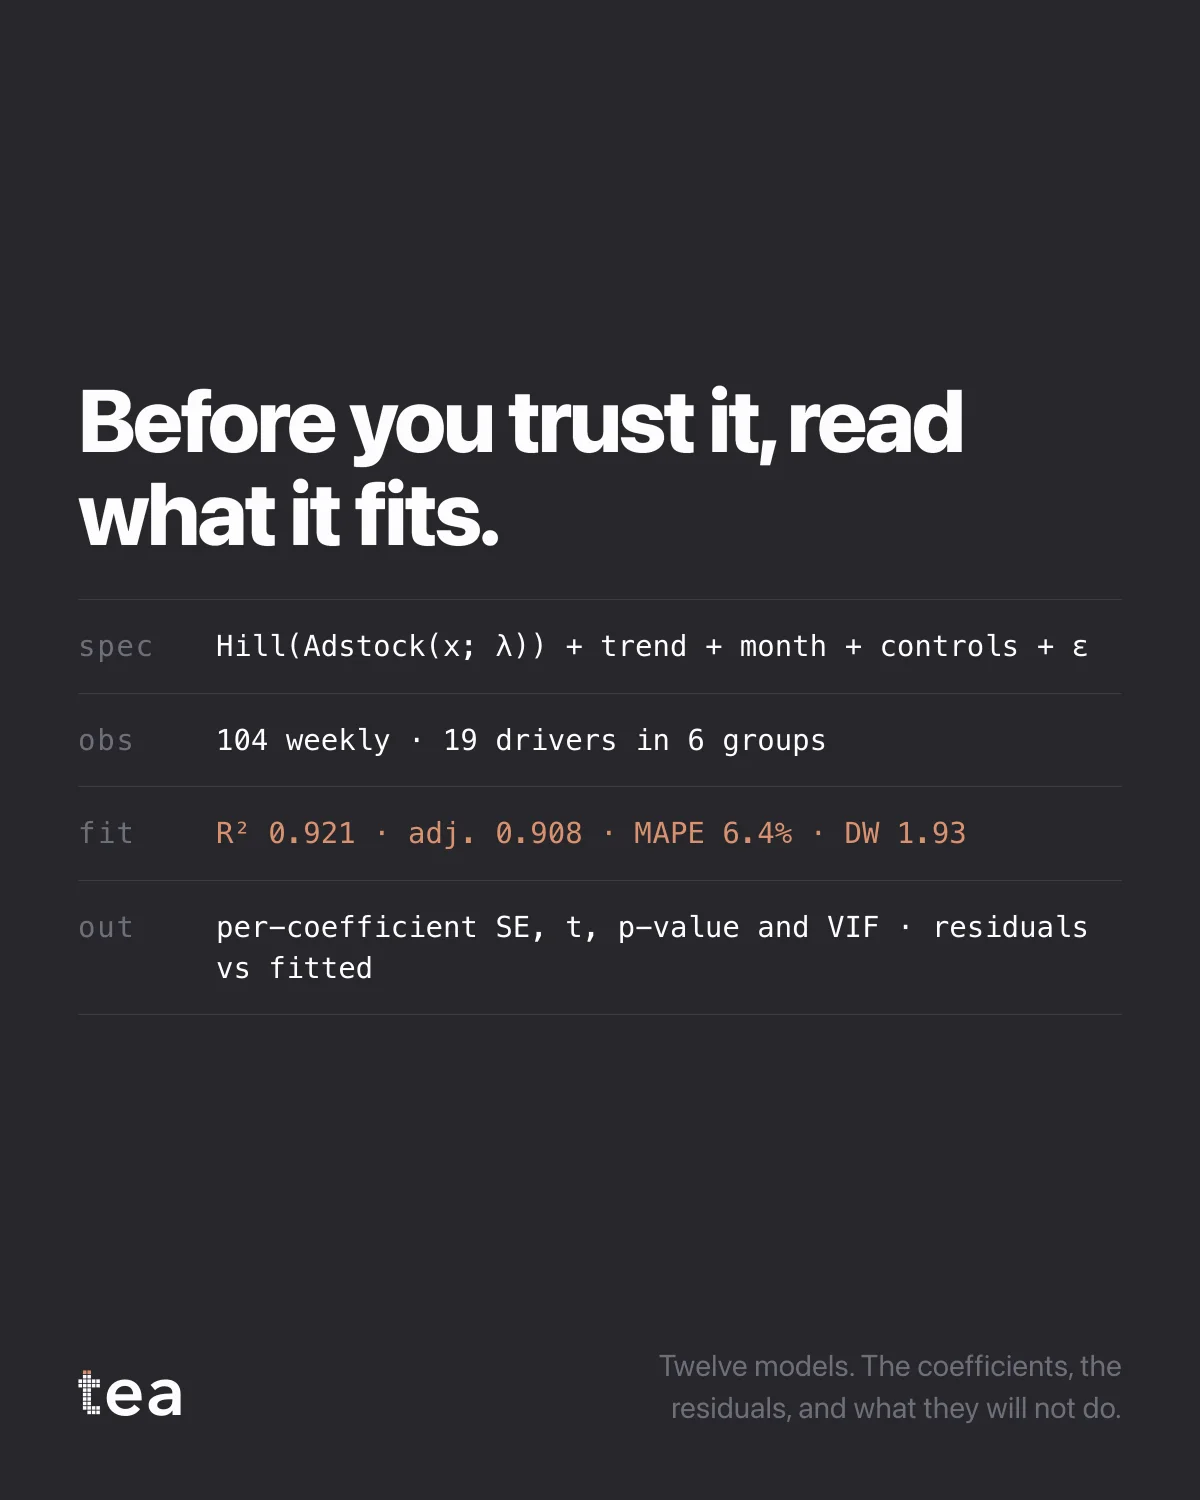
Antes de fiarte de él, lee qué ajusta.
Cuatro líneas, y son las cuatro que un responsable de datos pide antes que nada:
La especificación: Hill(Adstock(x; λ)) + tendencia + mes + controles + ε. Las observaciones: 104 filas semanales, 19 impulsores en 6 grupos. El ajuste: R² 0,921, ajustado 0,908, MAPE 6,4 %, Durbin-Watson 1,93. La salida: error estándar, t, p-valor y VIF por coeficiente, más los residuos frente a los valores ajustados.
Nada de esa lista es inusual. Lo inusual es que aparezca, en la misma pantalla que el resultado, sin que nadie lo pida.
La mayoría de las herramientas de analítica de marketing presentan una conclusión y dejan el modelo detrás de un ticket de soporte. Eso funciona hasta que quien recibe la conclusión es quien es dueño de los datos, y entonces falla por completo, porque la primera pregunta es siempre la misma: qué has ajustado, sobre qué, y cómo lo compruebo.
Tres razones por las que esto importa más allá de la cortesía con los analistas.
Un modelo que no se puede inspeccionar no se puede cuestionar, y un número que no se puede cuestionar no sobrevive a una revisión de finanzas. Se abandona en silencio en lugar de discutirse.
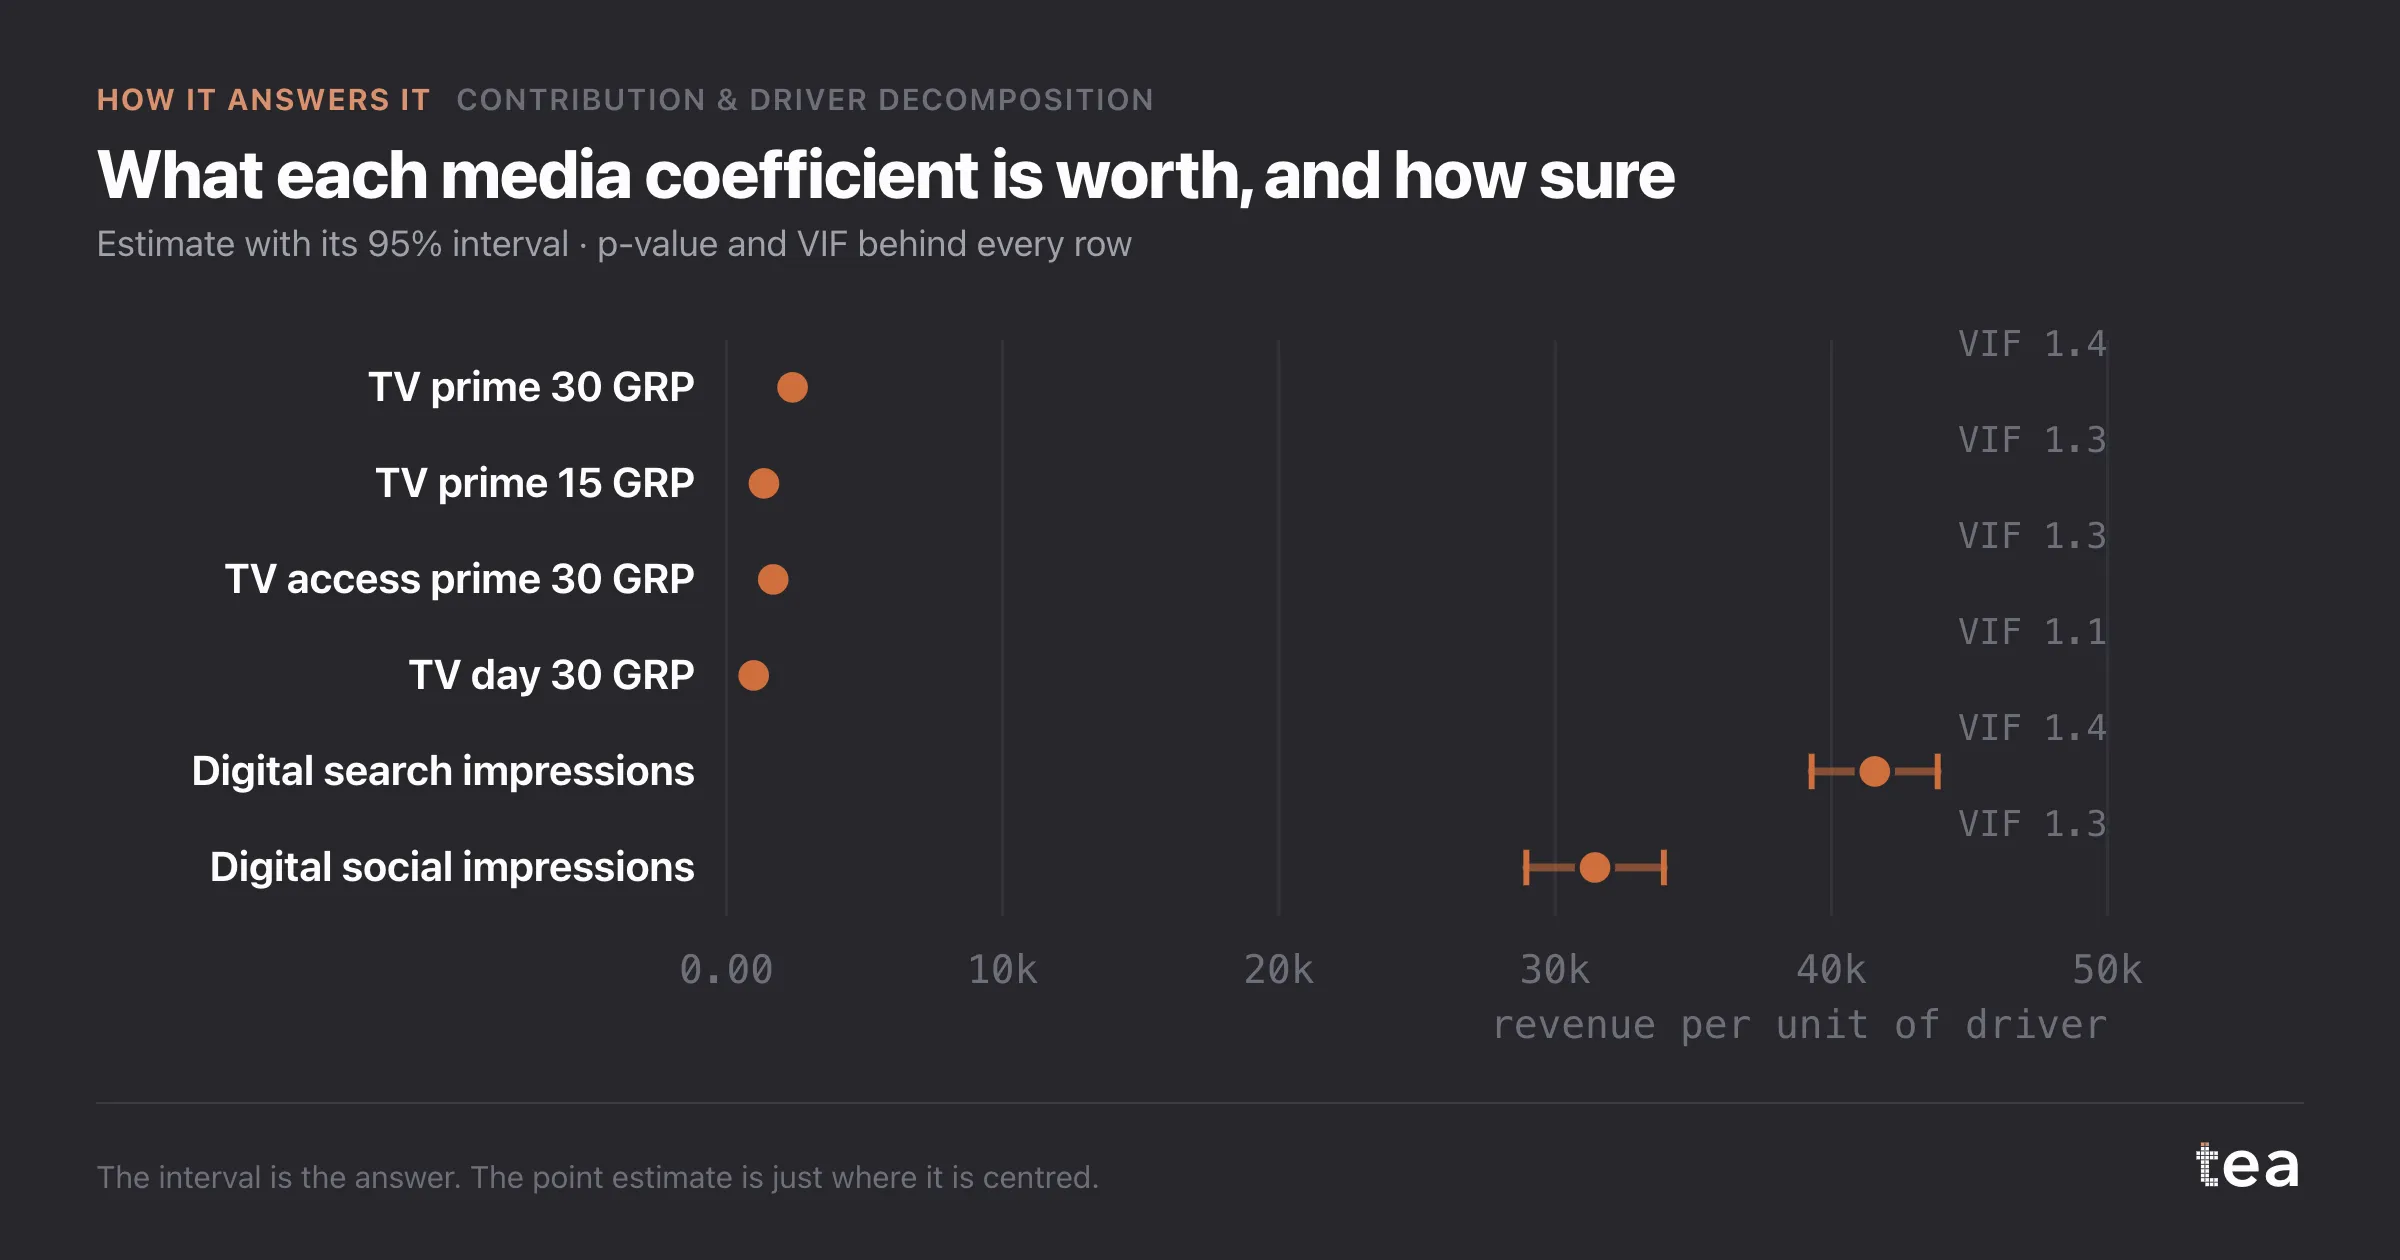
Los diagnósticos no son decoración. Un Durbin-Watson de 1,93 dice que los residuos no están fuertemente autocorrelacionados, que es la condición para que los intervalos de esos coeficientes signifiquen lo que dicen. Sin eso, cada error estándar de la página es optimista.
Y la columna del VIF es donde los modelos de medios fallan sin hacer ruido. Los canales que salen al aire juntos producen coeficientes que se intercambian el puesto. La contribución total puede ser correcta mientras cada impulsor por separado no es fiable, y solo los diagnósticos de colinealidad te lo dirán.
El principio con el que construimos es sencillo: todo lo que un revisor necesitaría para discrepar del resultado debe estar en la misma página que el resultado.
Doce modelos, los coeficientes, los residuos y lo que no harán.
Una nota sobre dónde duele más. Quien es dueño de los datos suele ser quien tiene que defender el modelo ante otra persona, y casi nunca es quien lo construyó. Todo lo que hay en esa ficha de cuatro líneas existe para que esa defensa sea posible sin una llamada.
La misma ficha también hace posible decir que no, y eso importa todavía más. Cuando el ajuste es pobre, o la colinealidad es alta, o el periodo es demasiado corto, un analista con los diagnósticos delante puede decir «con estos datos no» y demostrarlo. Sin ellos, las únicas opciones son aceptar el número o desconfiar de la herramienta, y las dos acaban mal.
tea, el producto
Tu archivo, esta pregunta
Quince análisis sobre un CSV de datos semanales, con los intervalos y los diagnósticos a la vista, y una frase clara cuando los datos no pueden responder. Gratis durante la beta, por invitación.
Pide una plaza en la beta→tea, el producto
Quince análisis econométricos con tu propio CSV: Contribución y descomposición por impulsor, curvas de saturación, elasticidades, asignación del presupuesto. Intervalos y diagnósticos a la vista, y una frase clara cuando el archivo no puede responder.
Gratis durante la beta, por invitación.
Pide una plaza en la beta →¿Te ha servido? Ejecútalo con tus propios datos.
tea ejecuta Contribución y descomposición por impulsor y otros catorce análisis con cualquier CSV semanal, en minutos. Gratis durante la beta, por invitación.