Eine Trendlinie passt auf alles. Genau das ist das Problem mit Trendlinien.
Legen Sie eine durch einen Random Walk, und Sie bekommen eine Steigung, ein R² und eine Geschichte. Die Steigung ist echt in dem Sinne, dass die Arithmetik stimmt. Sie ist nicht echt in dem Sinne, dass das nächste Jahr ihr folgen wird.
Bevor die Steigung also in einen Plan wandert, stellen Sie der Reihe eine einzige Frage: Ist das, was die Linie verfehlt hat, nur Rauschen, oder ist es die eigentliche Form der Daten?
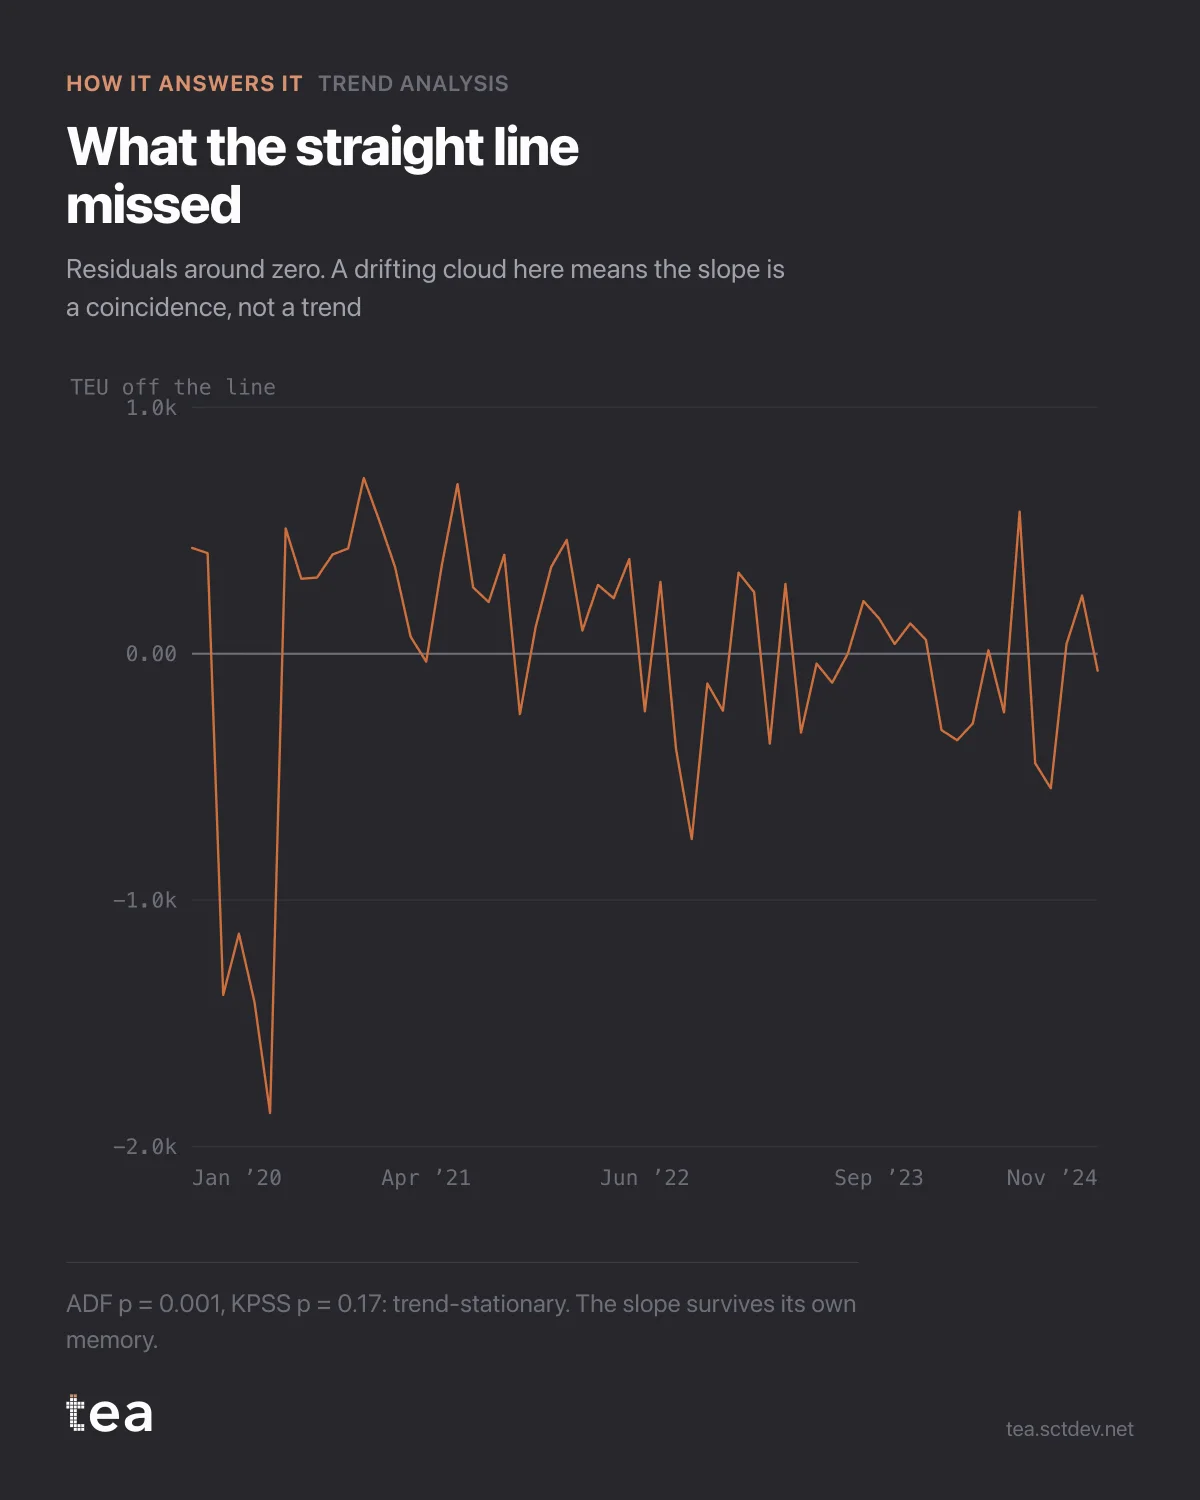
Die Grafik zeigt die Residuen. Dieselbe Anpassung wie vor drei Wochen, nur mit abgezogener Linie. Was Sie sehen wollen, ist eine Wolke um die Null, ohne Gedächtnis für sich selbst. Was Sie nicht sehen wollen, ist eine langsame Welle, in der auf einen Monat über der Linie drei weitere über der Linie folgen: Dann trägt die Reihe ihren eigenen Schwung mit sich, und eine Gerade ist dafür das falsche Instrument.
Zwei Tests entscheiden die Frage, und sie widersprechen sich mit Absicht.
ADF p = 0,001. Die Nullhypothese ist eine Einheitswurzel, also eine Reihe ohne festes Niveau, die dorthin wandert, wo der letzte Schock sie hinterlassen hat. Bei 0,001 wird diese Nullhypothese verworfen.
KPSS p = 0,17. Die Nullhypothese ist das Gegenteil: Die Reihe ist stationär um ihren Trend. Bei 0,17 hält diese Nullhypothese.
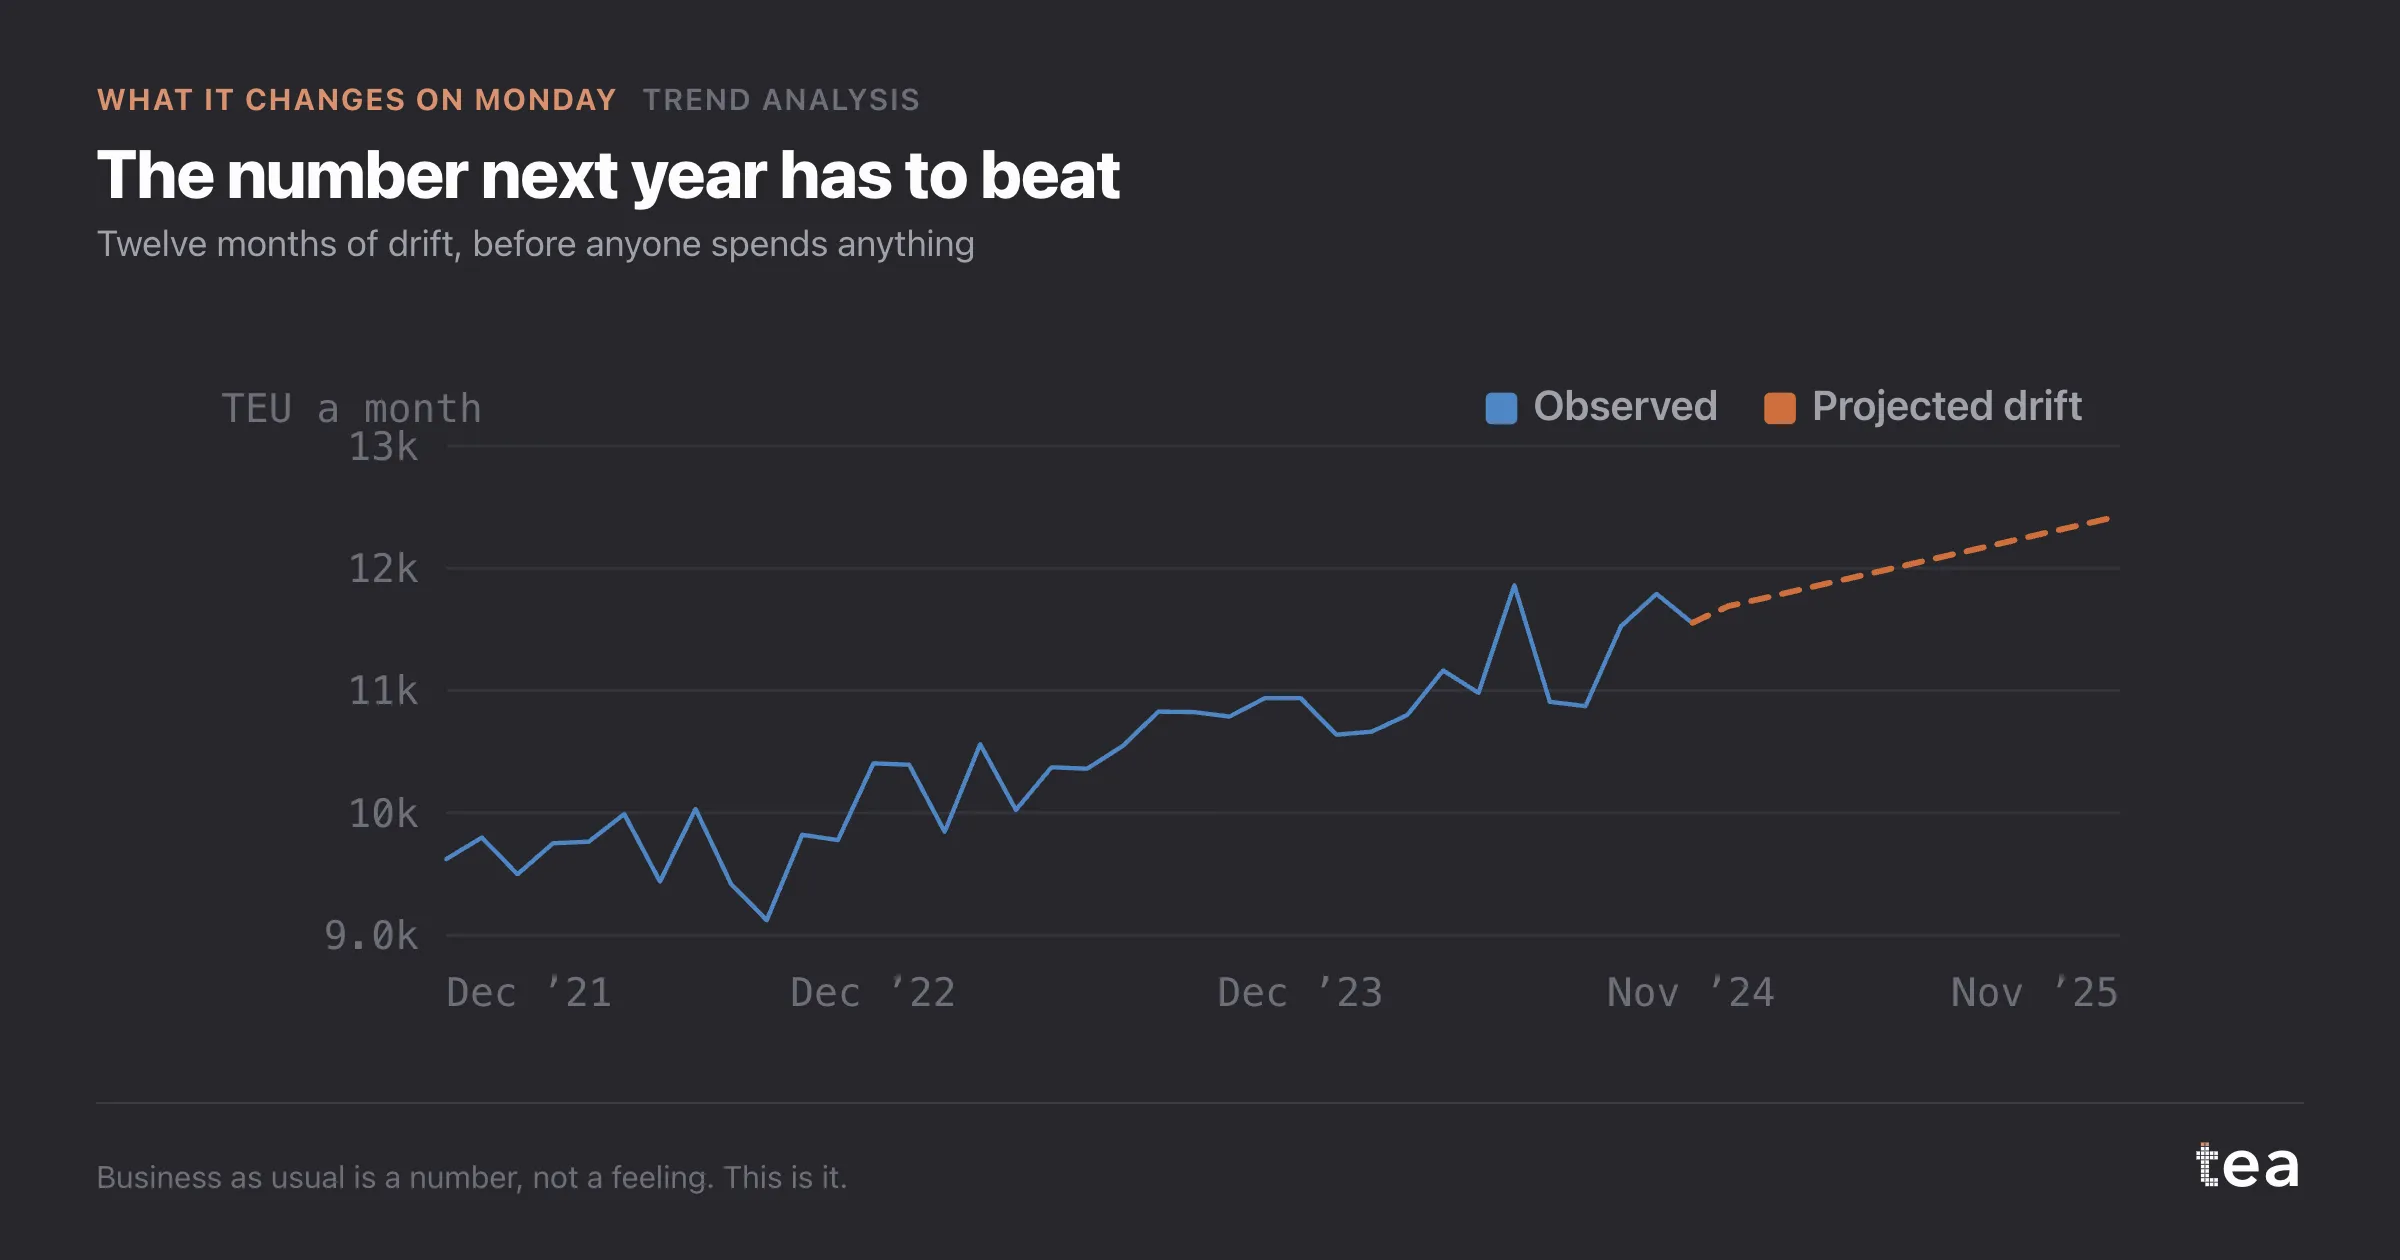
Beide zeigen in dieselbe Richtung, und das ist die einzige Konstellation, auf die man handeln sollte. Das Urteil lautet trendstationär: Diese Reihe hat ein Niveau, zu dem sie zurückkehrt, und dieses Niveau bewegt sich auf einer Geraden. Die Steigung übersteht ihr eigenes Gedächtnis.
Lassen Sie dieselben zwei Tests auf einen Random Walk los, und Sie bekommen das umgekehrte Paar, dazu eine Steigung, die Sie nie hätten zitieren dürfen. Das ist der Unterschied zwischen einem Trend und einem Zufall, der fünf Jahre gehalten hat.
Eine Zeile verdient es, zweimal gelesen zu werden: Der Standardfehler ist hier HAC, Bartlett mit Bandbreite n/2, mit Fixed-b-kritischen Werten. Auf Deutsch: Der Fehlerbalken wird verbreitert, weil die Residuen korreliert sind. Unabhängigkeit bei einer Monatsreihe einfach anzunehmen ist der Weg, auf dem ein p-Wert zum Theater wird.
Ein Trend ist keine Linie, die man zeichnet. Er ist eine Behauptung, die man prüft, und die Prüfung kann Nein sagen.
Es gibt einen praktischen Grund, warum das gerade im Marketing zählt. Inkrementalität, Media-Mix, Attribution: Sie alle messen eine Kampagne gegen ein Kontrafaktum, und dieses Kontrafaktum ist fast immer irgendeine Version dieser Linie. Wird die Linie auf einer Reihe geschätzt, die umherwandert, erbt jeder Euro gemessenen Beitrags weiter unten diesen Fehler, und er erbt ihn lautlos.
Zwei Tests und ein verbreiterter Standardfehler kosten ein paar Sekunden. Achtzehn Monate später herauszufinden, dass die Basis ein Random Walk war, kostet einen Budgetzyklus.
Die Grafik ist die echte Ausgabe der Trendanalyse in TEA. Die Diagnostik kommt mit der Steigung, nicht auf Nachfrage.
tea, das Produkt
Ihre Datei, diese Frage
Fünfzehn Analysen auf einer CSV mit Wochendaten, mit Intervallen und Diagnosen offen gezeigt, und einem klaren Satz, wenn die Daten keine Antwort hergeben. Kostenlos während der Beta, auf Einladung.
Einen Platz in der Beta anfragen→tea, das Produkt
Fünfzehn ökonometrische Analysen auf Ihrer eigenen CSV: Trendanalyse, Sättigungskurven, Elastizitäten, Budgetaufteilung. Intervalle und Diagnosen offen gezeigt, und ein klarer Satz, wenn die Datei keine Antwort hergibt.
Kostenlos während der Beta, auf Einladung.
Einen Platz in der Beta anfragen →Hat es Ihnen gefallen? Probieren Sie es mit Ihren eigenen Daten.
tea führt Trendanalyse und vierzehn weitere Analysen auf jeder CSV mit Wochendaten aus, in Minuten. Kostenlos während der Beta, auf Einladung.