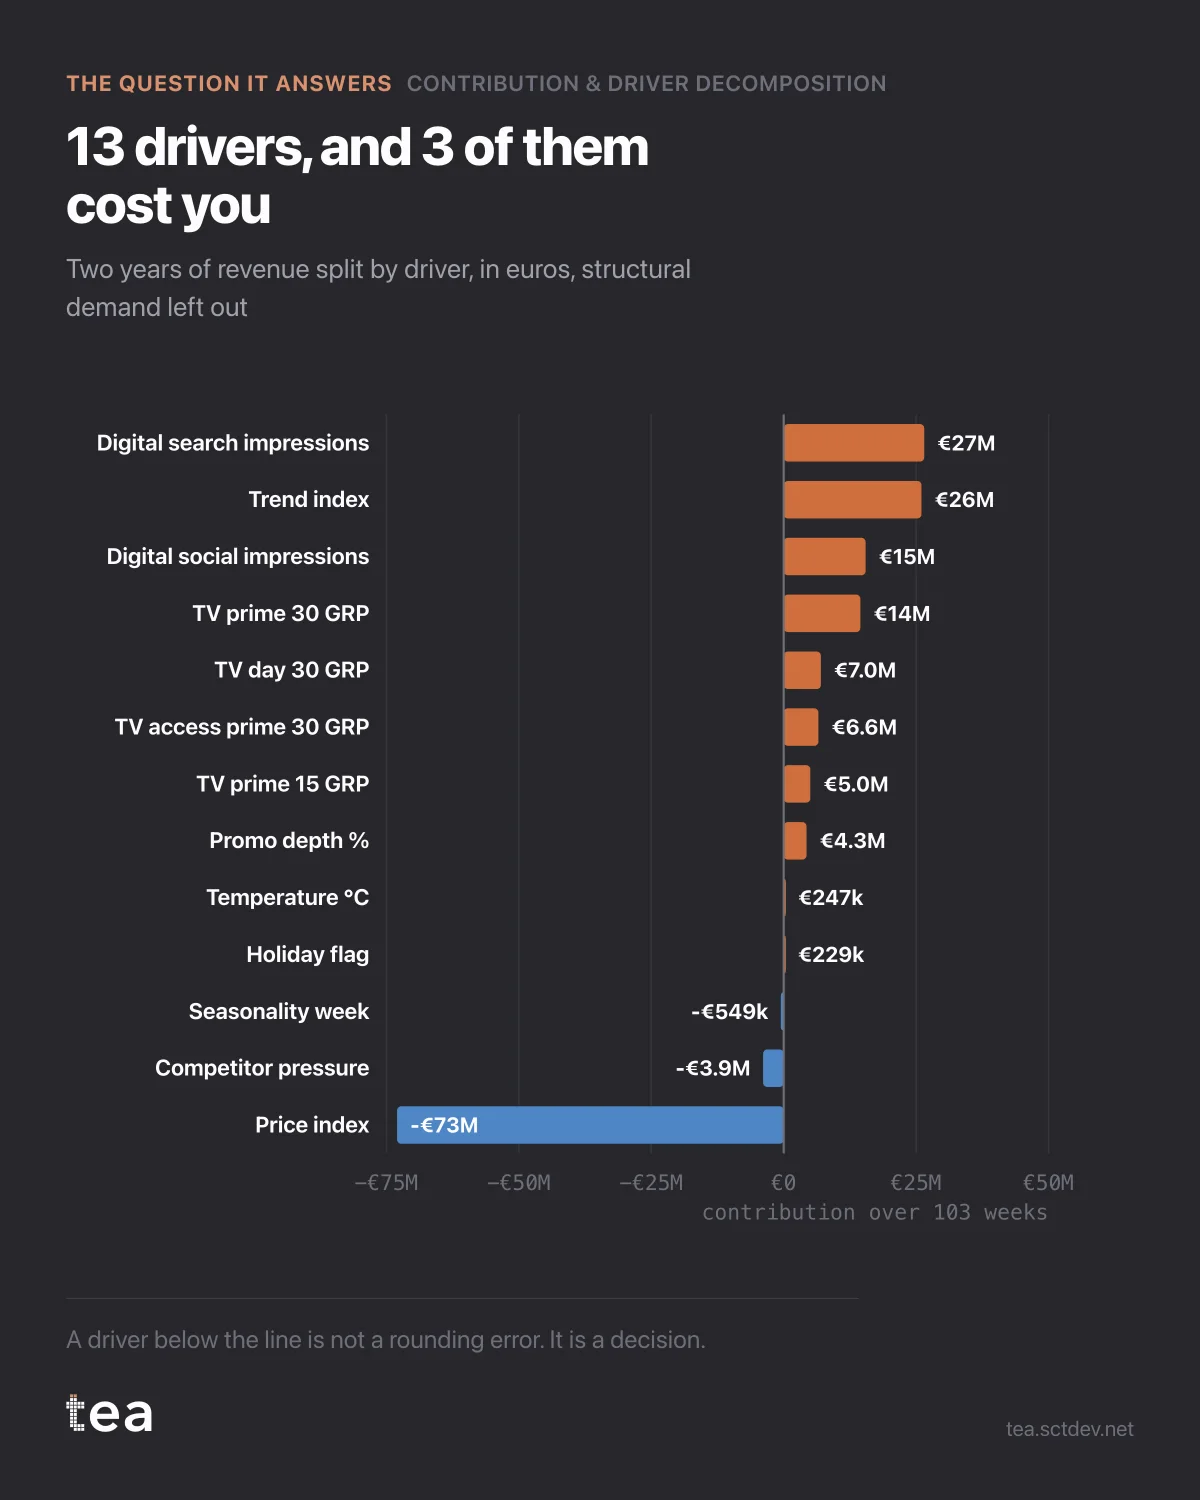
Zwei Jahre Umsatz im Lebensmittelhandel, aufgeteilt nach dem, was ihn bewegt hat. Dreizehn Treiber, in Euro, die strukturelle Nachfrage herausgelassen, damit der Rest lesbar bleibt.
Drei der dreizehn liegen unter der Linie. Genau dieser Teil fehlt den meisten Reportings, weil sie nur zählen, was geholfen hat.
Digitale Suche trug 26,5 Mio. € bei. Der strukturelle Trend, den niemand gekauft hat, 26,0 Mio. €. Digital Social 15,5 Mio. €. Dann die TV-Dayparts, dann die Promotion.
Und der Preis nahm 73,0 Mio. € weg.
Dieser eine Balken ist länger als alle Media-Balken zusammen, und er ist der Grund, warum es diese Analyse gibt. Ein Jahr, in dem Media 75,1 Mio. € hinzufügte und der Preis 73,0 Mio. € abzog, sieht in der GuV flach aus und ist darunter alles andere als flach. Berichten Sie nur den Media-Beitrag, haben Sie ein Drittel dessen beschrieben, was passiert ist, und der Leser zieht Schlüsse über das Marketing aus einer Zahl, die in einem Pricing-Meeting entschieden wurde.
Drei Eigenschaften dieser Zerlegung, die ein Kanalbericht nicht liefern kann.
Die Treiber werden gemeinsam geschätzt, also ist jeder um die anderen bereinigt. TV bekommt keine Anerkennung für die Woche, in der es neben einer Promotion lief, und die Promotion keine für die Saison, in der sie lief.
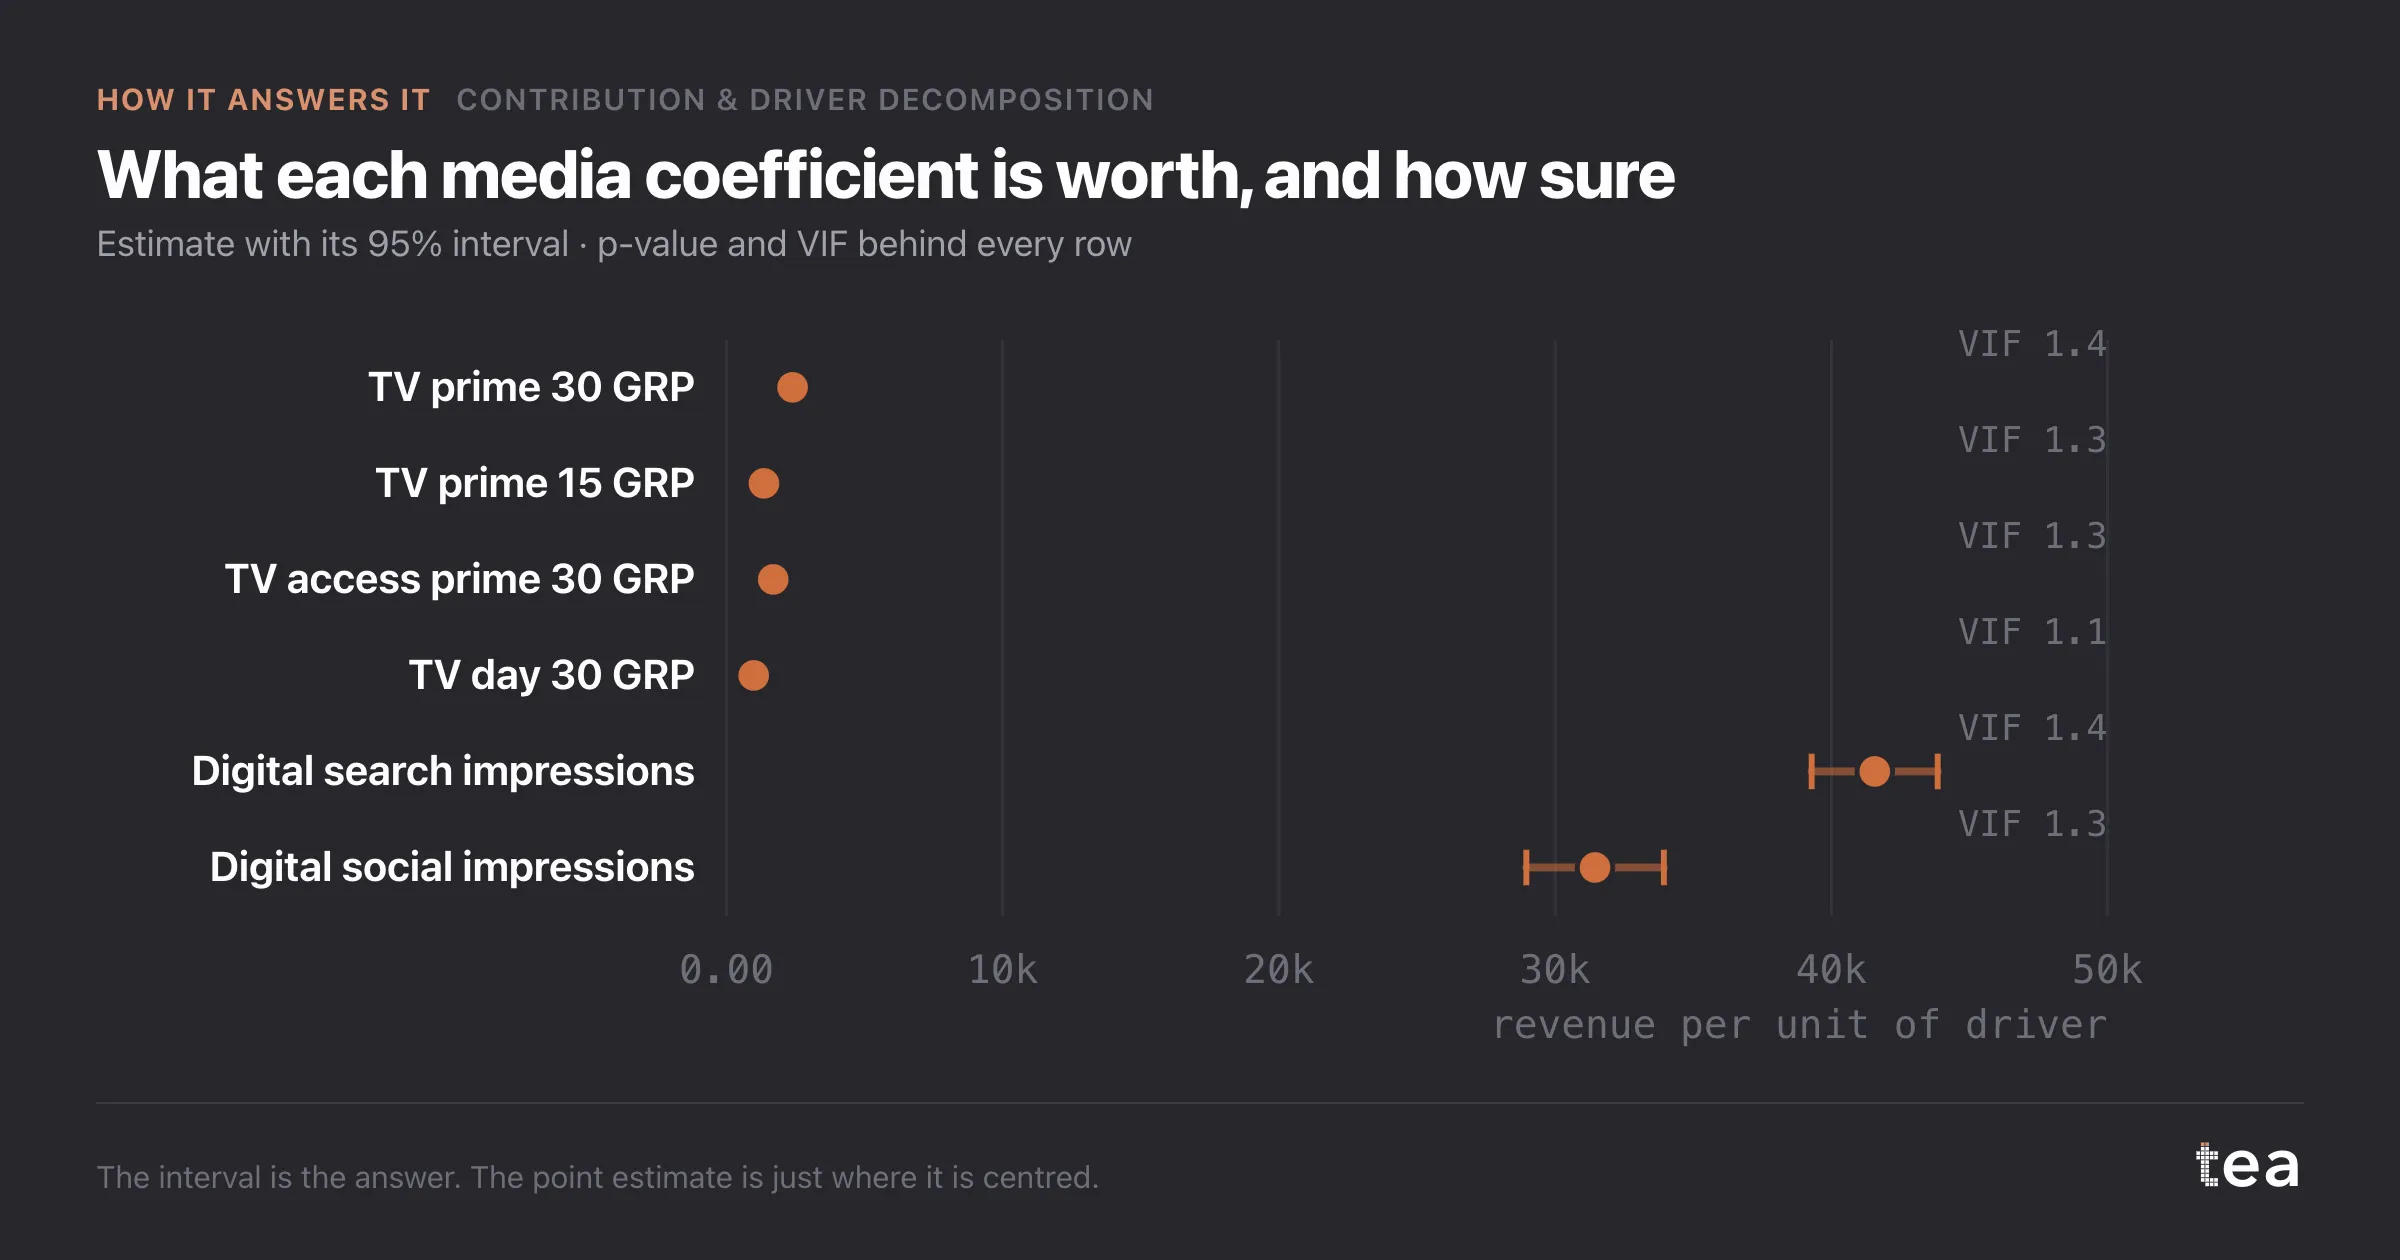
Negative Beiträge dürfen negativ sein. Preis, Wettbewerbsdruck und der Saisonterm nehmen hier etwas weg, und sie auf null zu zwingen würde ihre Wirkung stillschweigend auf alles verschieben, was übrig bleibt.
Und die Aufteilung ist in Ergebnis-Einheiten, nicht in Indexpunkten. Euro gehören in einen Business Case. Koeffizienten in einen Anhang.
Was das mit dem Gespräch macht, ist der interessante Teil. Ein Marketingteam, das sagen kann „wir haben 75,1 Mio. € hinzugefügt, und die Preisbewegungen haben 73,0 Mio. € gekostet“, sitzt in einem völlig anderen Meeting als eines, das sagen kann „unsere Kanäle lagen 12 % im Plus“. Das Erste ist eine Aussage über das Geschäft. Das Zweite eine Aussage über das Dashboard.
Die strukturelle Nachfrage, die 346,6 Mio. €, die ohnehin gekommen wären, ist in dieser Ansicht bewusst ausgeblendet. Sie ist dreißigmal größer als der größte Hebel und würde jeden anderen Balken zu einem Strich plattdrücken.
Ein Hinweis dazu, wie die Datei aussehen muss. Eine Zeile pro Periode, eine Spalte pro Treiber und genug Wochen, in denen sich die Treiber nicht alle gemeinsam bewegen. Hier sind es 103 Wochen und dreizehn Treiber, und die Treiber wurden unterschiedlich geflightet: Das ist die Bedingung, unter der ein Modell sie überhaupt trennen kann.
Der Fehlerfall ist ein Plan, in dem immer alles gleichzeitig läuft. Dann sind TV, Suche und Promotion dieselbe Spalte unter drei Namen, und keine Methode trennt sie. Ist das Ihre Datei, ist die ehrliche Ausgabe eine Warnung statt eines Diagramms, und sie sollte vor der Präsentation kommen.
Das Diagramm ist die tatsächliche Ausgabe von Beitrag und Zerlegung nach Treibern in TEA, ausgeführt auf einer Beispieldatei, die jeder herunterladen kann.
tea, das Produkt
Ihre Datei, diese Frage
Fünfzehn Analysen auf einer CSV mit Wochendaten, mit Intervallen und Diagnosen offen gezeigt, und einem klaren Satz, wenn die Daten keine Antwort hergeben. Kostenlos während der Beta, auf Einladung.
Einen Platz in der Beta anfragen→tea, das Produkt
Fünfzehn ökonometrische Analysen auf Ihrer eigenen CSV: Beitrag und Zerlegung nach Treibern, Sättigungskurven, Elastizitäten, Budgetaufteilung. Intervalle und Diagnosen offen gezeigt, und ein klarer Satz, wenn die Datei keine Antwort hergibt.
Kostenlos während der Beta, auf Einladung.
Einen Platz in der Beta anfragen →Hat es Ihnen gefallen? Probieren Sie es mit Ihren eigenen Daten.
tea führt Beitrag und Zerlegung nach Treibern und vierzehn weitere Analysen auf jeder CSV mit Wochendaten aus, in Minuten. Kostenlos während der Beta, auf Einladung.