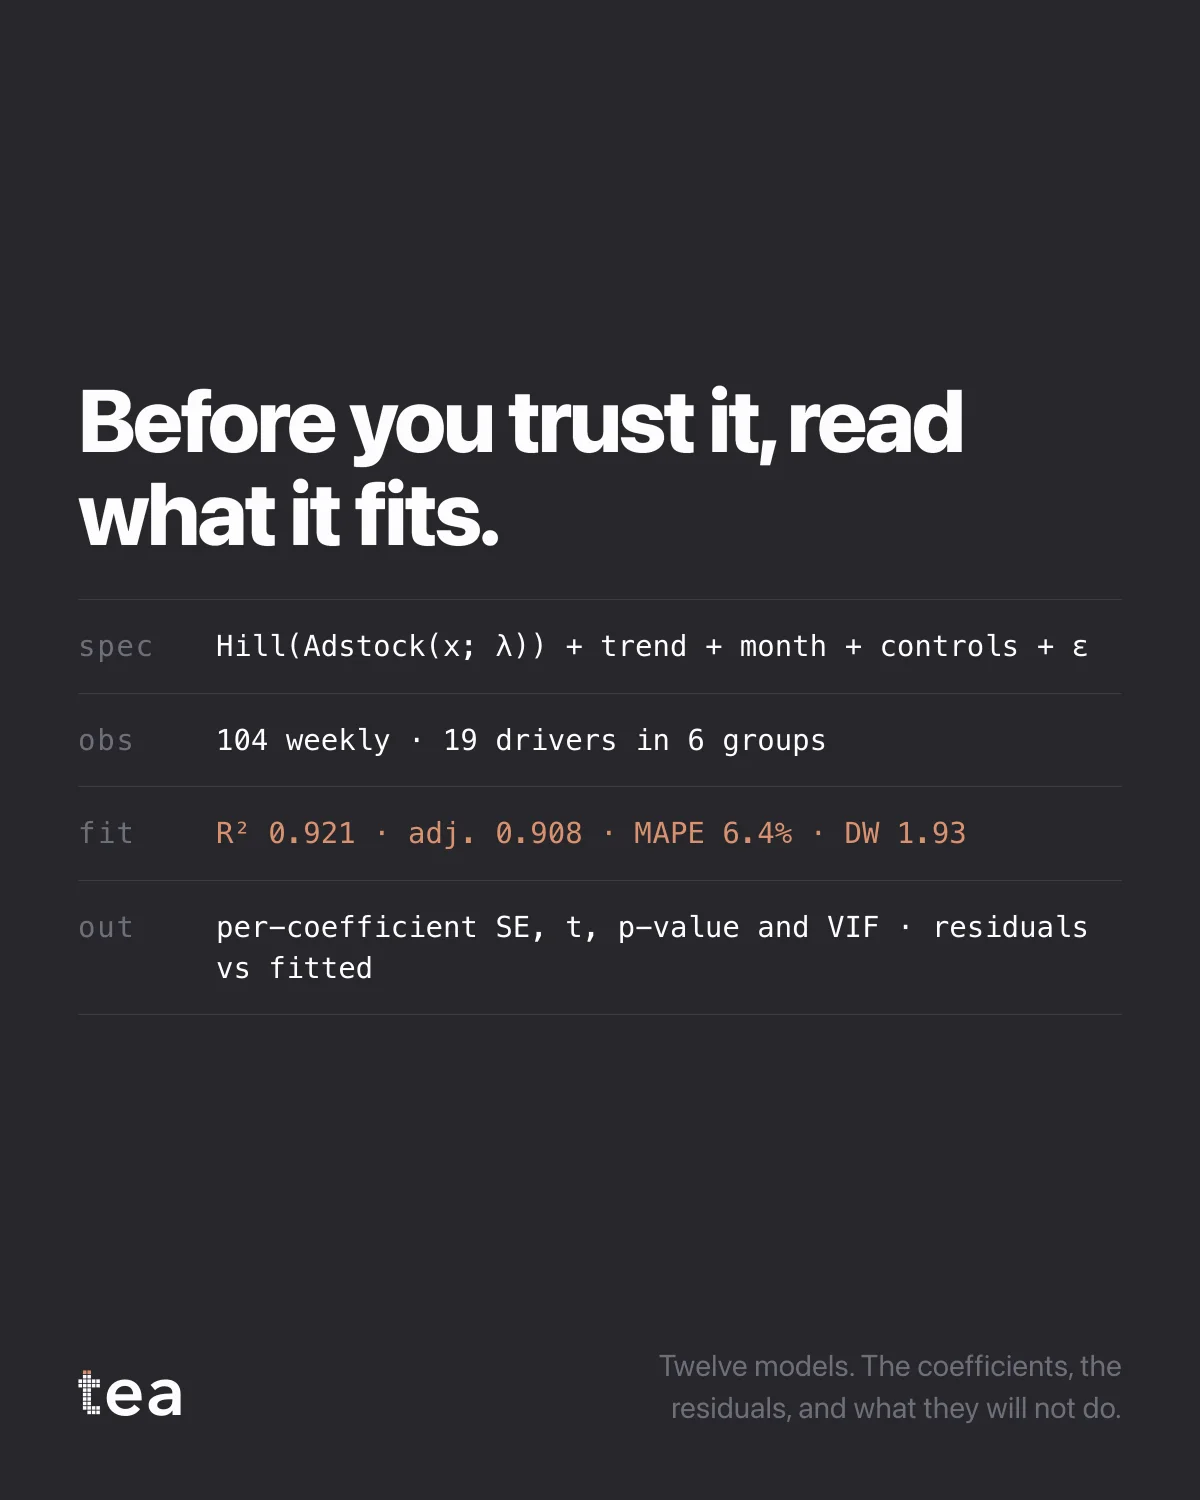
Bevor Sie ihm vertrauen, lesen Sie, was es schätzt.
Vier Zeilen, und es sind genau die vier, nach denen ein Datenverantwortlicher vor allem anderen fragt:
Die Spezifikation: Hill(Adstock(x; λ)) + Trend + Monat + Kontrollvariablen + ε. Die Beobachtungen: 104 Wochenzeilen, 19 Treiber in 6 Gruppen. Die Anpassung: R² 0,921, korrigiert 0,908, MAPE 6,4 %, Durbin-Watson 1,93. Die Ausgabe: je Koeffizient Standardfehler, t, p-Wert und VIF, dazu Residuen gegen angepasste Werte.
Nichts auf dieser Liste ist ungewöhnlich. Ungewöhnlich ist, dass sie überhaupt erscheint, auf demselben Bildschirm wie das Ergebnis, ohne dass jemand danach fragen muss.
Die meisten Marketing-Analytics-Tools präsentieren eine Schlussfolgerung und halten das Modell hinter einem Support-Ticket. Das geht so lange gut, bis die Person, die die Schlussfolgerung bekommt, die Person ist, der die Daten gehören. Dann scheitert es vollständig, denn die erste Frage ist immer dieselbe: Was haben Sie geschätzt, auf welchen Daten, und wie kann ich das prüfen?
Drei Gründe, warum das mehr ist als Höflichkeit gegenüber Analysten.
Ein Modell, das man nicht einsehen kann, kann man nicht anfechten, und eine Zahl, die man nicht anfechten kann, übersteht keine Prüfung durch das Controlling. Sie wird nicht widerlegt, sondern still fallen gelassen.
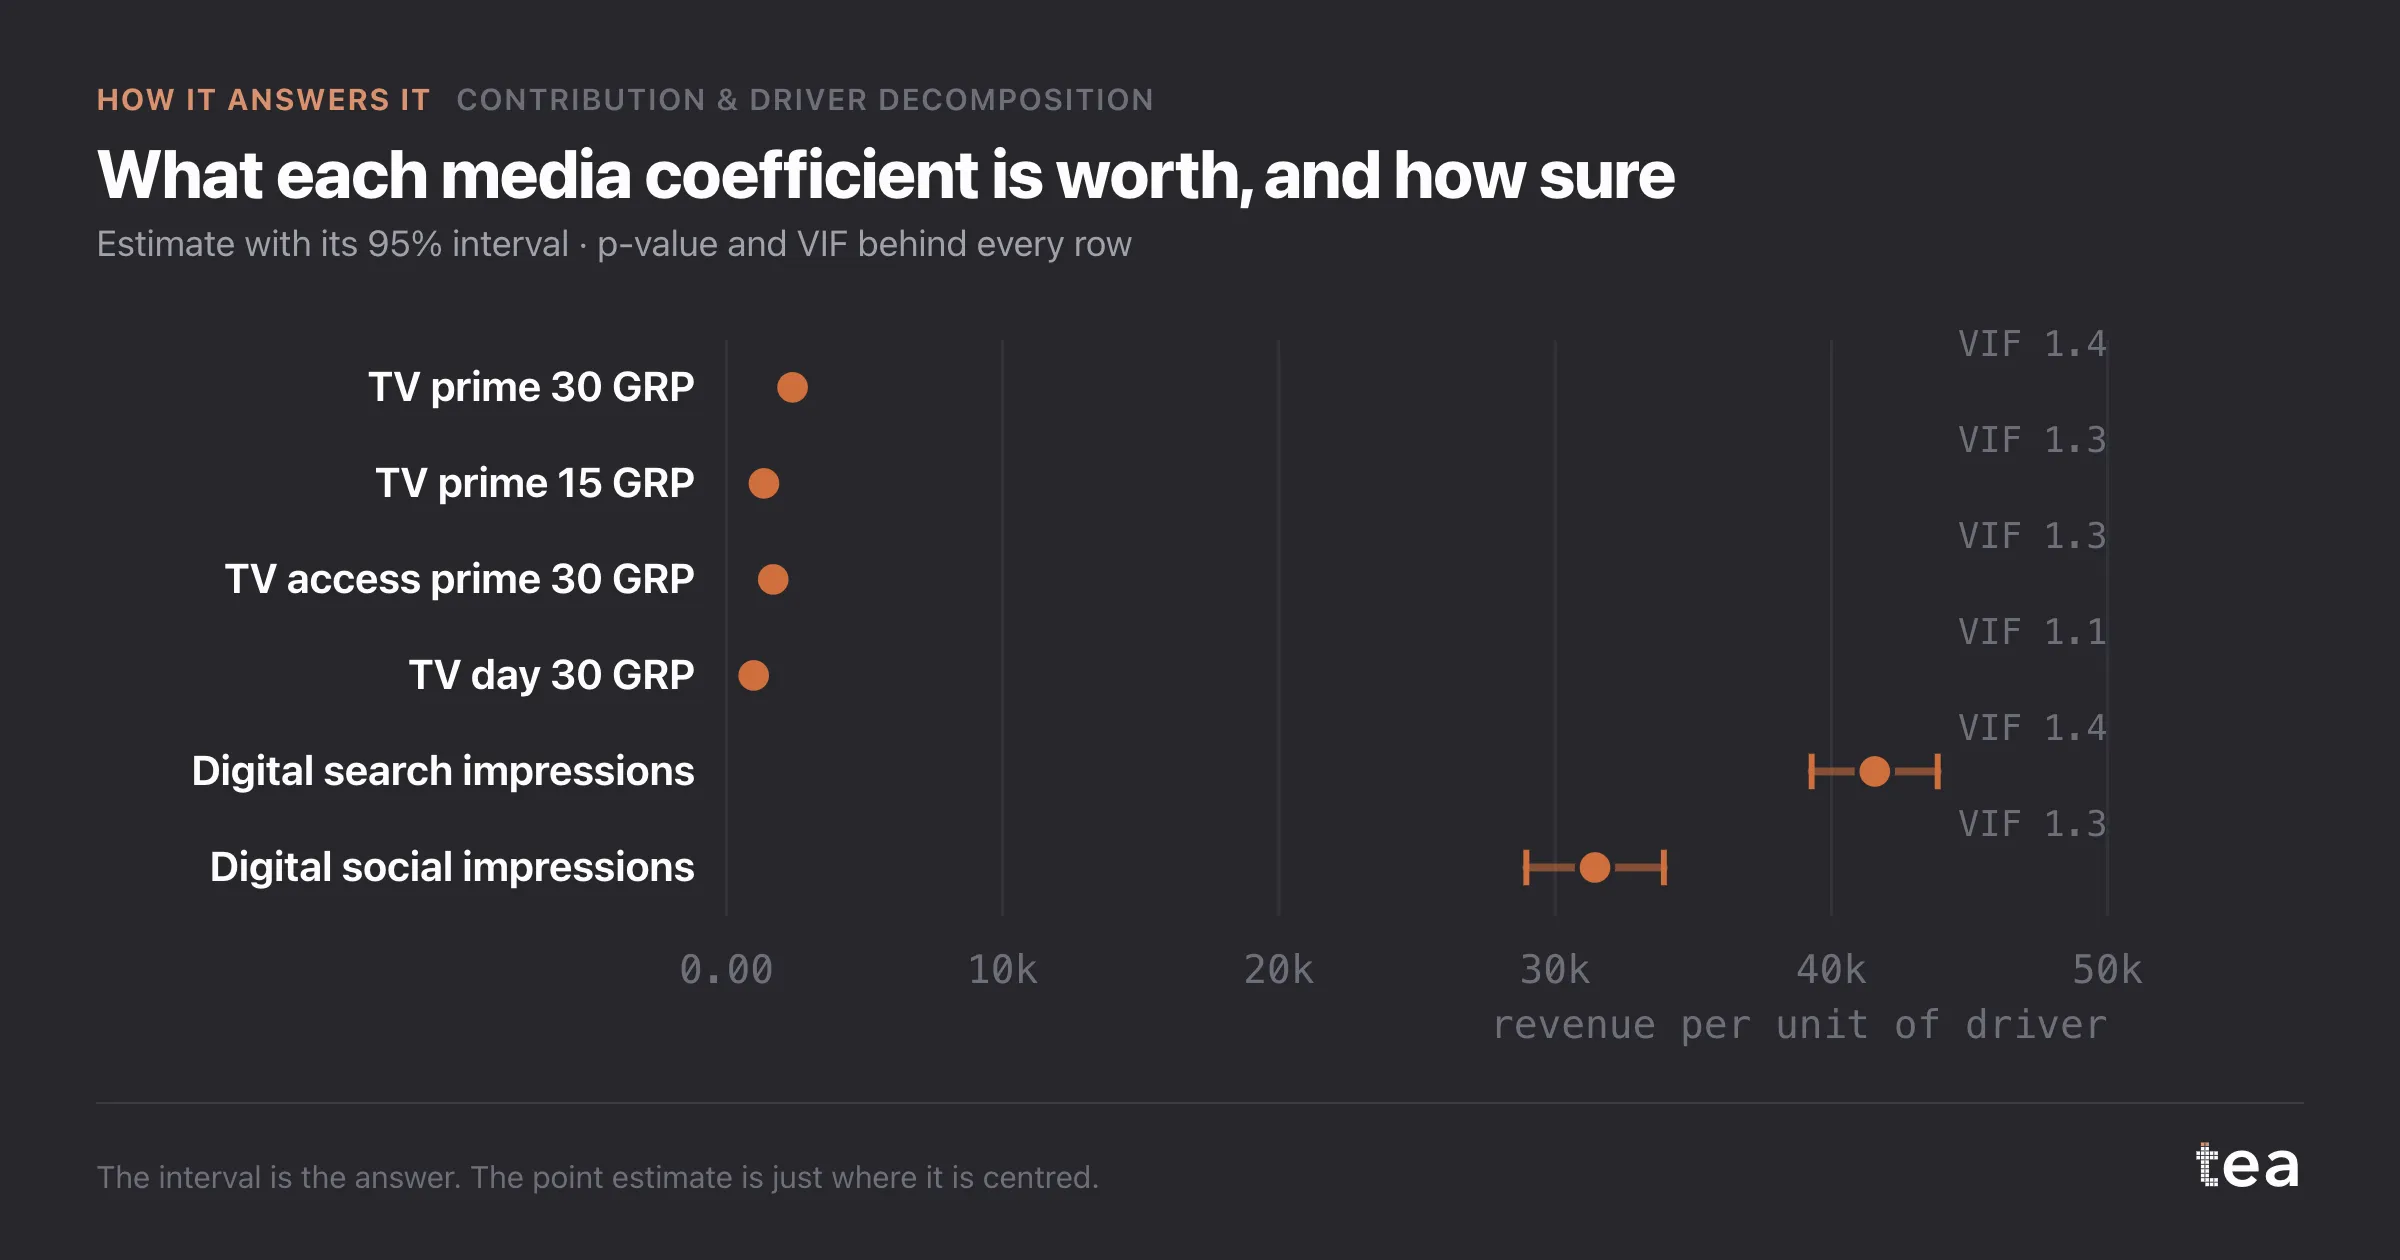
Diagnostik ist keine Dekoration. Ein Durbin-Watson von 1,93 sagt, dass die Residuen nicht stark autokorreliert sind, und genau unter dieser Bedingung bedeuten die Intervalle der Koeffizienten, was sie behaupten. Ohne sie ist jeder Standardfehler auf der Seite zu optimistisch.
Und in der VIF-Spalte scheitern Mediamodelle leise. Kanäle, die gemeinsam geflightet werden, erzeugen Koeffizienten, die untereinander die Plätze tauschen. Der Gesamtbeitrag kann stimmen, während jeder einzelne Treiber unzuverlässig ist, und nur die Kollinearitätsdiagnostik sagt es Ihnen.
Das Prinzip, nach dem wir bauen, ist einfach: Alles, was jemand braucht, um dem Ergebnis zu widersprechen, gehört auf dieselbe Seite wie das Ergebnis.
Zwölf Modelle, die Koeffizienten, die Residuen und das, was sie nicht leisten.
Ein Hinweis darauf, wo das am meisten schmerzt. Die Person, der die Daten gehören, ist meist diejenige, die das Modell vor jemand anderem verteidigen muss, und sie ist fast nie diejenige, die es gebaut hat. Alles auf dieser vierzeiligen Karte existiert, damit diese Verteidigung ohne einen Anruf möglich ist.
Dieselbe Karte macht auch eine Absage möglich, und das wiegt schwerer. Ist die Anpassung schlecht, die Kollinearität hoch oder der Zeitraum zu kurz, kann eine Analystin mit der Diagnostik vor Augen „nicht mit diesen Daten“ sagen, und zwar mit Belegen. Ohne sie bleibt nur, die Zahl zu akzeptieren oder dem Tool zu misstrauen, und beides endet schlecht.
tea, das Produkt
Ihre Datei, diese Frage
Fünfzehn Analysen auf einer CSV mit Wochendaten, mit Intervallen und Diagnosen offen gezeigt, und einem klaren Satz, wenn die Daten keine Antwort hergeben. Kostenlos während der Beta, auf Einladung.
Einen Platz in der Beta anfragen→tea, das Produkt
Fünfzehn ökonometrische Analysen auf Ihrer eigenen CSV: Beitrag und Zerlegung nach Treibern, Sättigungskurven, Elastizitäten, Budgetaufteilung. Intervalle und Diagnosen offen gezeigt, und ein klarer Satz, wenn die Datei keine Antwort hergibt.
Kostenlos während der Beta, auf Einladung.
Einen Platz in der Beta anfragen →Hat es Ihnen gefallen? Probieren Sie es mit Ihren eigenen Daten.
tea führt Beitrag und Zerlegung nach Treibern und vierzehn weitere Analysen auf jeder CSV mit Wochendaten aus, in Minuten. Kostenlos während der Beta, auf Einladung.