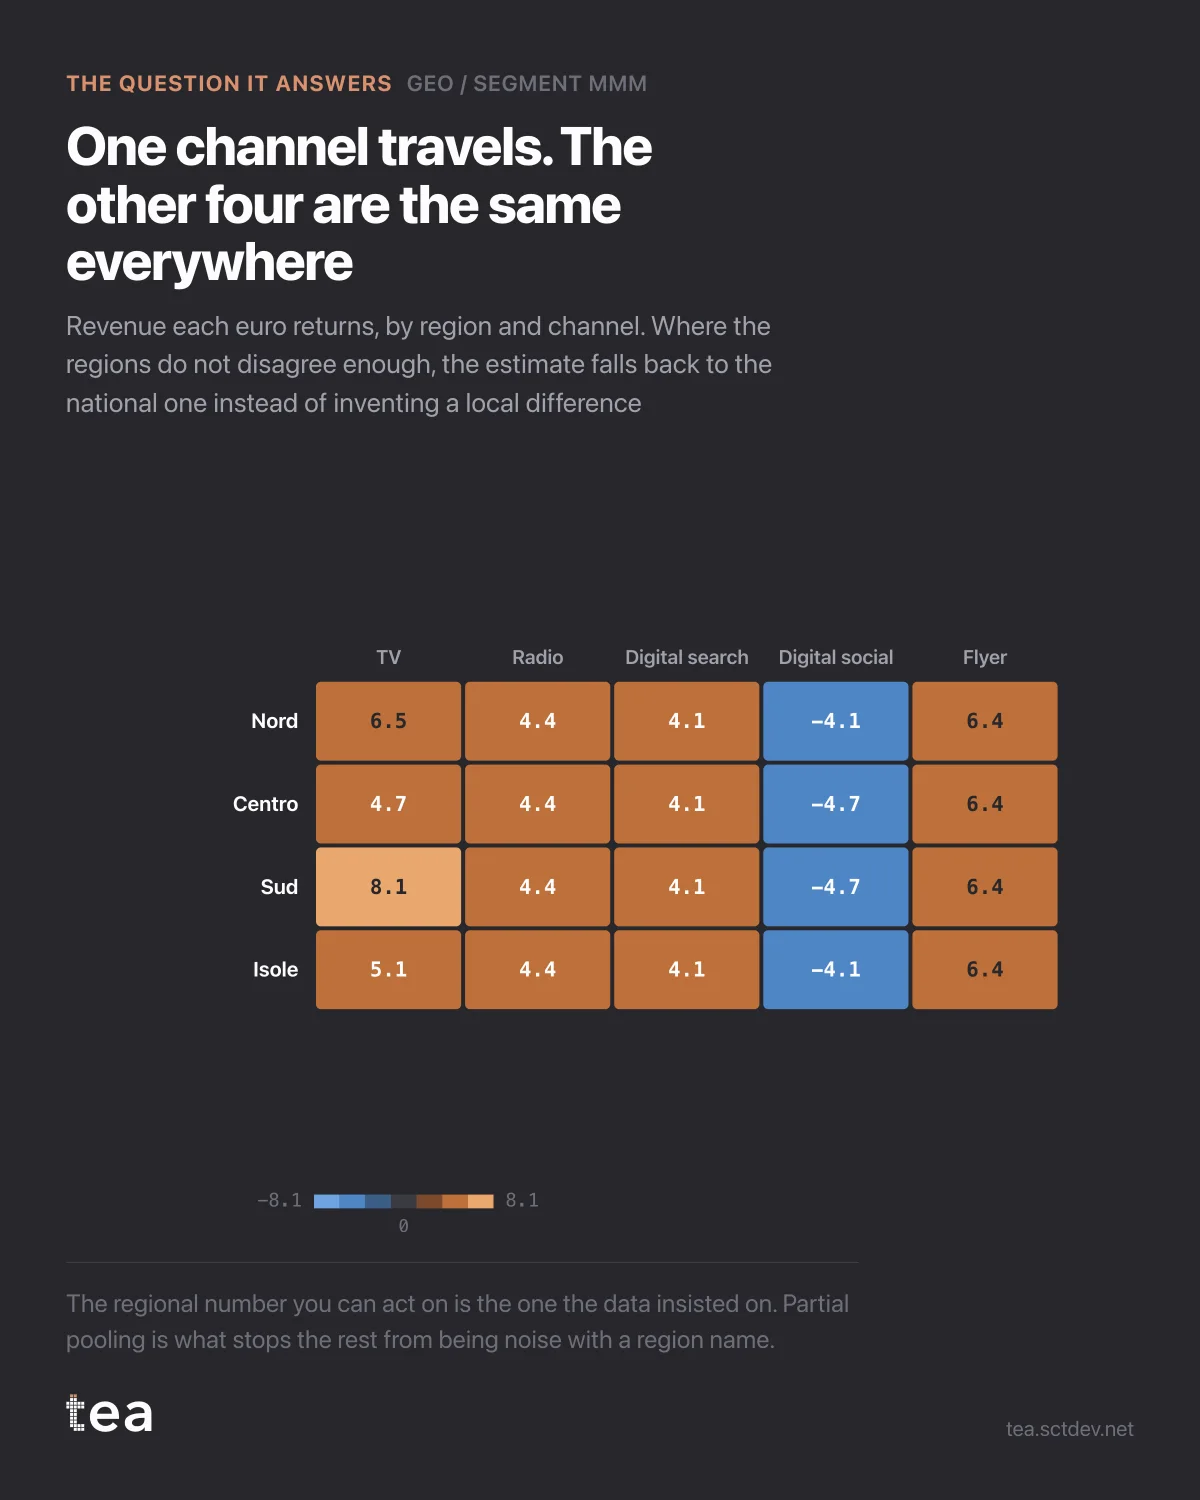
Vier Regionen, fünf Kanäle, und das Raster zeigt, was jeder Euro in jeder Zelle zurückgibt.
Lesen Sie die Zeilen entlang, und die meisten Zahlen wiederholen sich. Radio bringt überall 4,4. Digitale Suche überall 4,1. Handzettel überall 6,4. Nur TV ändert sich: 8,1 im Süden, 4,7 in der Mitte, der Norden und die Inseln dazwischen.
Das ist kein faules Modell. Das ist partielles Pooling, das genau das tut, wofür es da ist.
Hier ist das Problem, das es löst. Schätzen Sie jede Region einzeln, bekommen Sie vier unabhängige Schätzungen, jede auf einem Viertel der Daten, jede mit einem breiten Intervall und jede frei, dorthin zu wandern, wohin ihr eigenes Rauschen sie trägt. Dann baut jemand einen regionalen Plan auf einem Unterschied, der nie echt war. Schätzen Sie stattdessen alle zusammen, bekommen Sie eine nationale Zahl, die jeden echten lokalen Unterschied versteckt.
Partielles Pooling liegt dazwischen. Die Schätzung jeder Region wird zum nationalen Mittel gezogen, und wie stark, hängt davon ab, wie viel Evidenz diese Region liefert und wie sehr sich die Regionen wirklich unterscheiden. Verhält sich ein Kanal tatsächlich je Region anders, trennen sich die Schätzungen. Liegt der scheinbare Unterschied innerhalb dessen, was Rauschen erzeugen würde, fallen sie auf die nationale Zahl zurück.
Dieses Raster ist also eine Karte davon, wo es lokale Evidenz gibt. TV hat sie. Die anderen vier Kanäle haben sie nicht, in dieser Datei, bei dieser Länge der Historie.
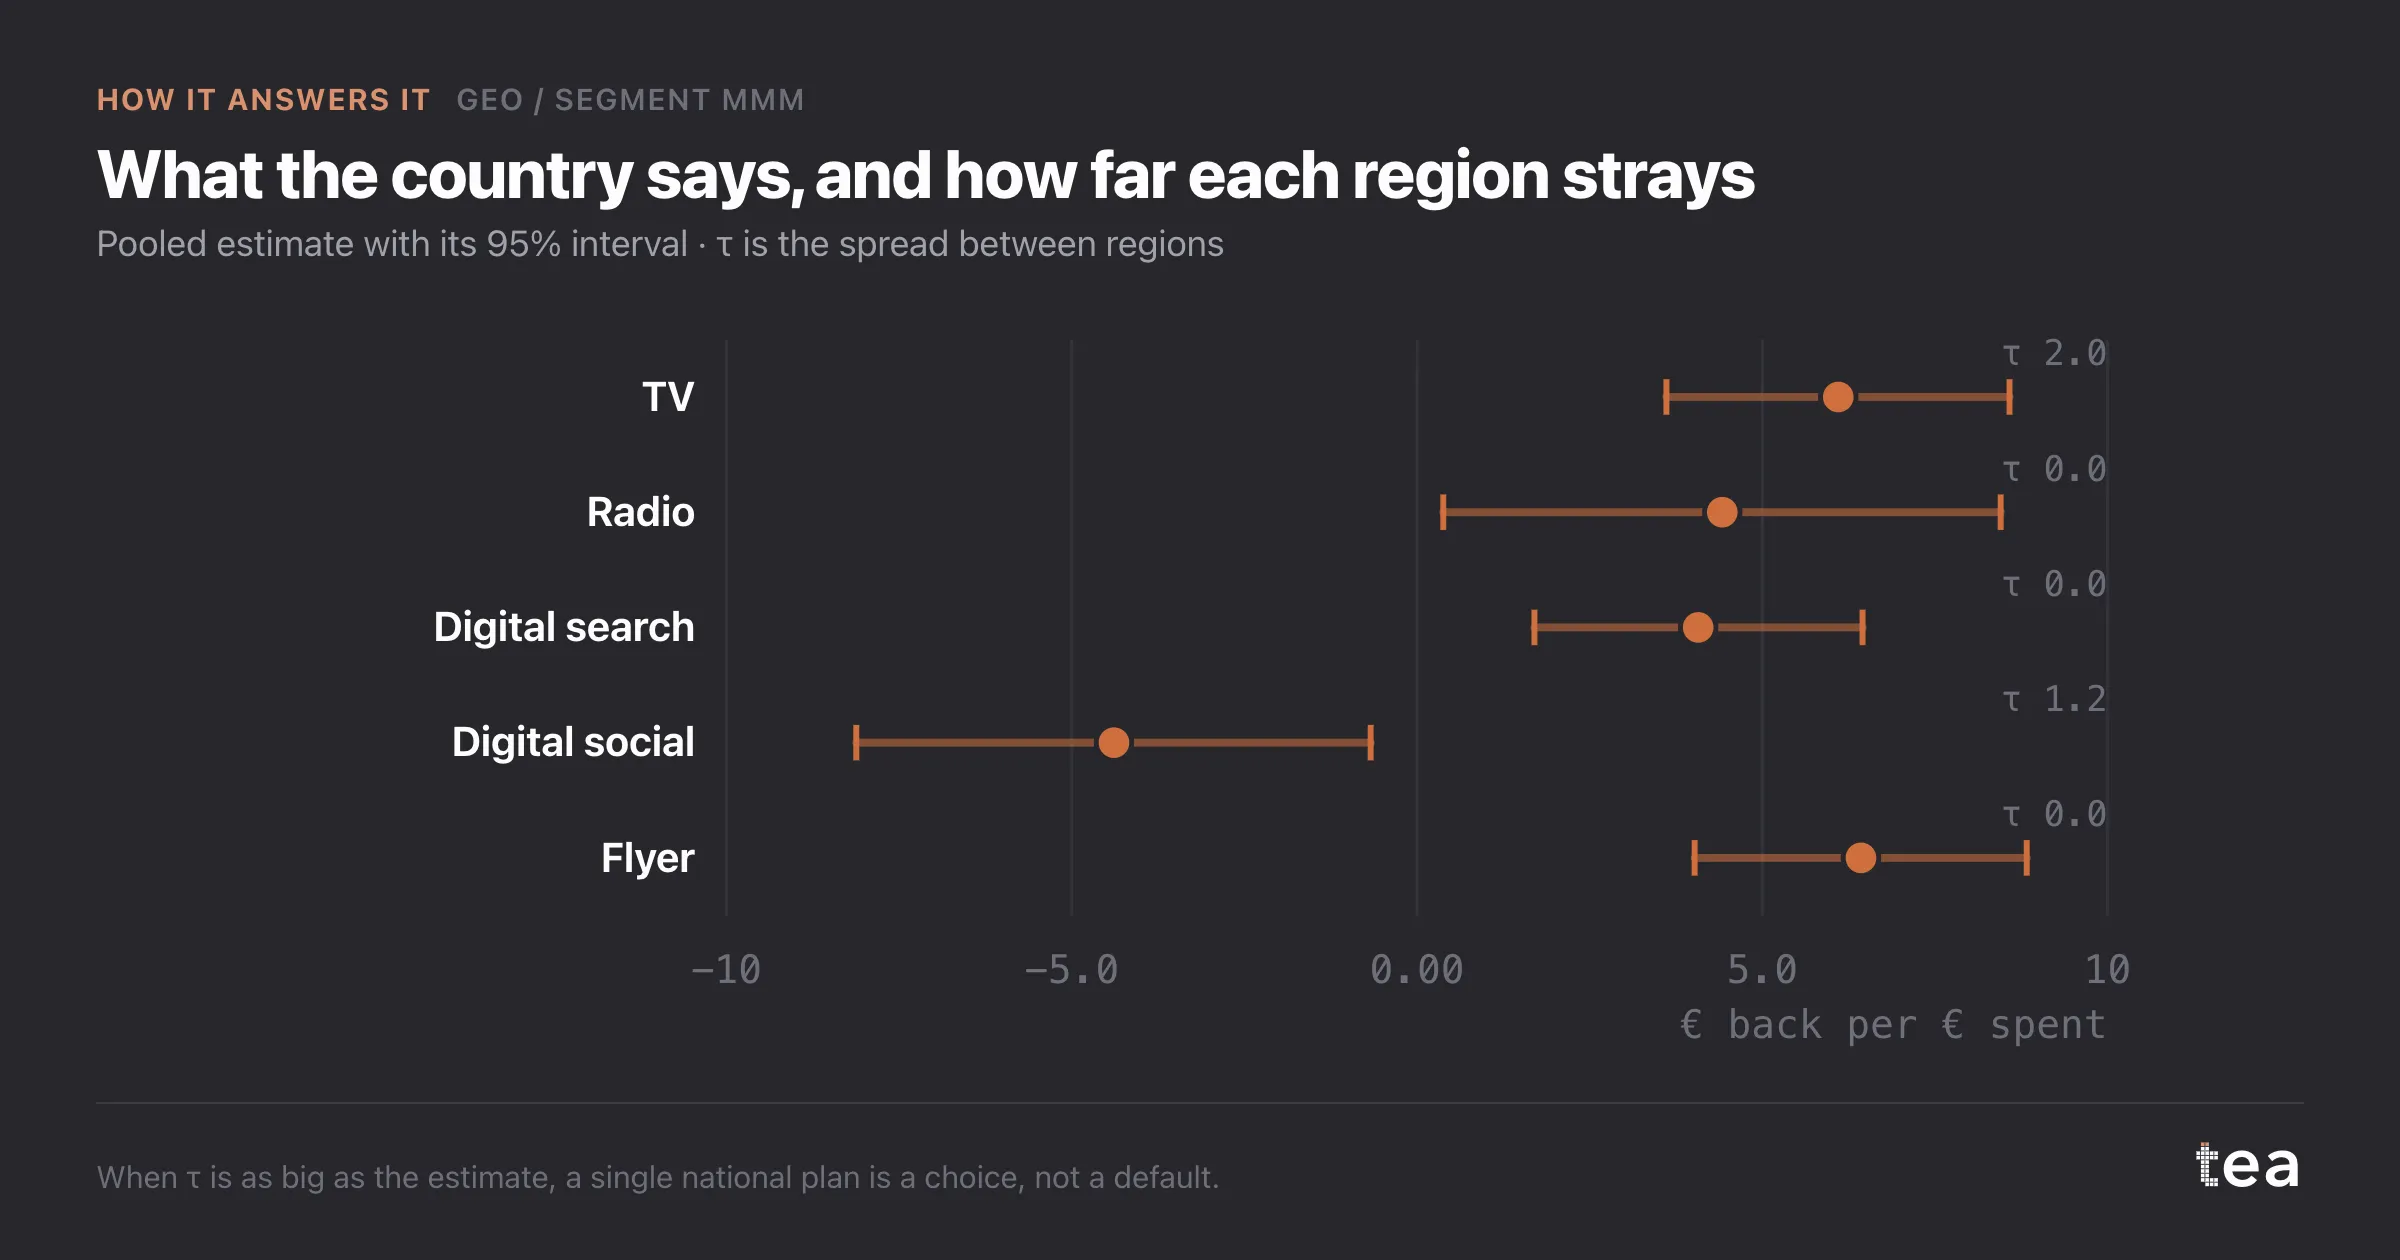
Was das für einen Plan bedeutet, ist direkt. TV kaufen Sie regional ein, weil der Unterschied echt ist und 3,4 Ertragspunkte zwischen der besten und der schlechtesten Region ausmacht. Den Rest kaufen Sie national, weil die regionalen Unterschiede, gegen die Sie planen würden, sich nicht von Rauschen unterscheiden lassen.
Das ist ein viel kürzerer und viel sicherer Plan als der, den vier getrennte Regressionen hervorgebracht hätten.
Die praktische Voraussetzung ist eine Spalte. Dieselbe Wochendatei, die Sie für ein nationales Modell verwenden würden, ergänzt um eine Spalte für Region, Stadt, Filialgruppe oder Segment, und genug Perioden pro Segment, dass jedes etwas zu sagen hat. Vier Regionen über 104 Wochen sind 416 Zeilen, das ist komfortabel.
Was Sie zurückbekommen, ist eine Entscheidung, die die meisten Teams jedes Jahr aus dem Bauch treffen: Wie lokal soll der Plan sein? Der Bauch antwortet meist mit der Organisationsstruktur, weil es ein Regionalteam gibt, oder mit der lautesten Anfrage. Die Varianz in den Daten antwortet anders, und billiger.
Und wenn das Raster vollständig einheitlich zurückkommt, ist auch das ein Ergebnis. Es bedeutet, dass der nationale Plan der richtige ist und Sie keine Managementzeit mehr auf regionale Ausnahmen verwenden müssen, die der Markt nicht stützt.
Das Diagramm ist die tatsächliche Ausgabe von Geo-/Segment-MMM in TEA, ausgeführt auf einer Beispieldatei, die jeder herunterladen kann.
tea, das Produkt
Ihre Datei, diese Frage
Fünfzehn Analysen auf einer CSV mit Wochendaten, mit Intervallen und Diagnosen offen gezeigt, und einem klaren Satz, wenn die Daten keine Antwort hergeben. Kostenlos während der Beta, auf Einladung.
Einen Platz in der Beta anfragen→tea, das Produkt
Fünfzehn ökonometrische Analysen auf Ihrer eigenen CSV: Geo-/Segment-MMM, Sättigungskurven, Elastizitäten, Budgetaufteilung. Intervalle und Diagnosen offen gezeigt, und ein klarer Satz, wenn die Datei keine Antwort hergibt.
Kostenlos während der Beta, auf Einladung.
Einen Platz in der Beta anfragen →Hat es Ihnen gefallen? Probieren Sie es mit Ihren eigenen Daten.
tea führt Geo-/Segment-MMM und vierzehn weitere Analysen auf jeder CSV mit Wochendaten aus, in Minuten. Kostenlos während der Beta, auf Einladung.