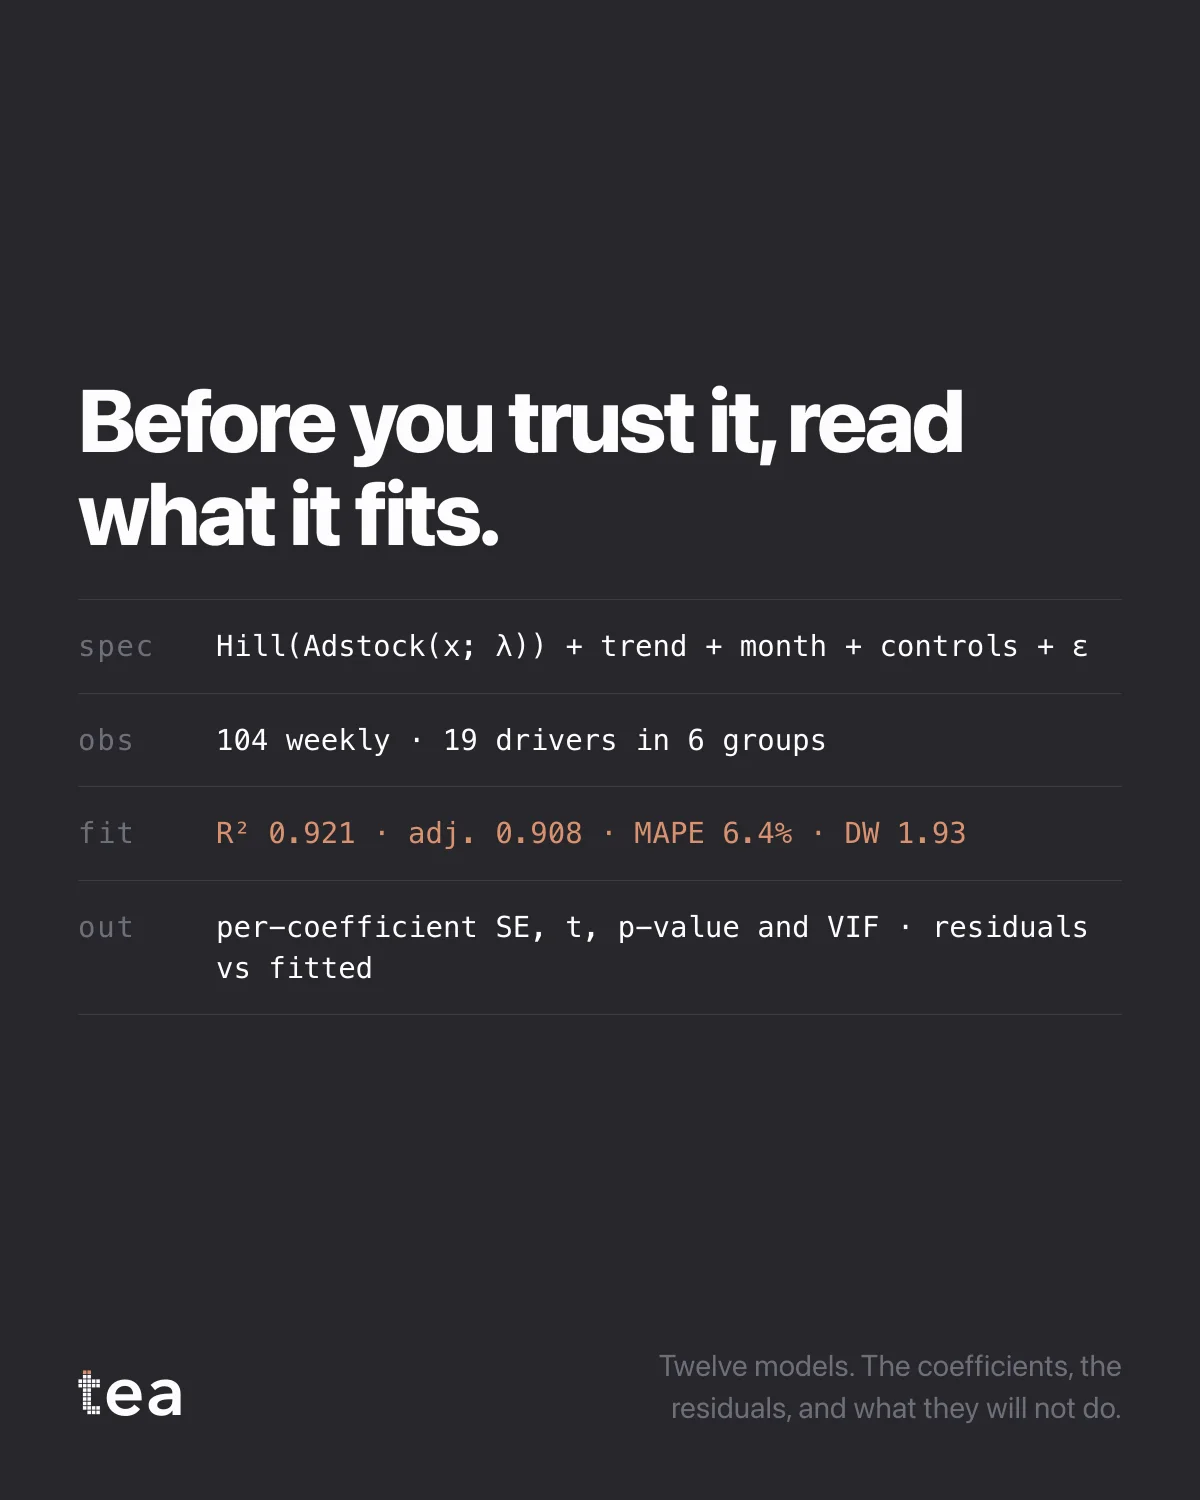
Prima di fidarti, leggi che cosa stima.
Quattro righe, e sono le quattro che un data manager chiede prima di qualsiasi altra cosa:
La specificazione: Hill(Adstock(x; λ)) + trend + mese + controlli + ε. Le osservazioni: 104 righe settimanali, 19 driver in 6 gruppi. L’adattamento: R² 0,921, corretto 0,908, MAPE 6,4%, Durbin-Watson 1,93. L’output: errore standard, t, p-value e VIF per ogni coefficiente, più i residui contro i valori stimati.
In quell’elenco non c’è niente di insolito. L’insolito è che compaia, sulla stessa schermata del risultato, senza che nessuno l’abbia chiesto.
La maggior parte degli strumenti di marketing analytics presenta una conclusione e tiene il modello dietro un ticket di assistenza. Funziona finché chi riceve la conclusione non è chi possiede i dati, e a quel punto smette di funzionare del tutto, perché la prima domanda è sempre la stessa: che cosa hai stimato, su che cosa, e come lo verifico.
Tre ragioni per cui questo conta, al di là della cortesia verso gli analisti.
Un modello che non puoi ispezionare non può essere contestato, e un numero che non può essere contestato non sopravvive al confronto con una review della finanza. Viene lasciato cadere in silenzio, invece di essere discusso.
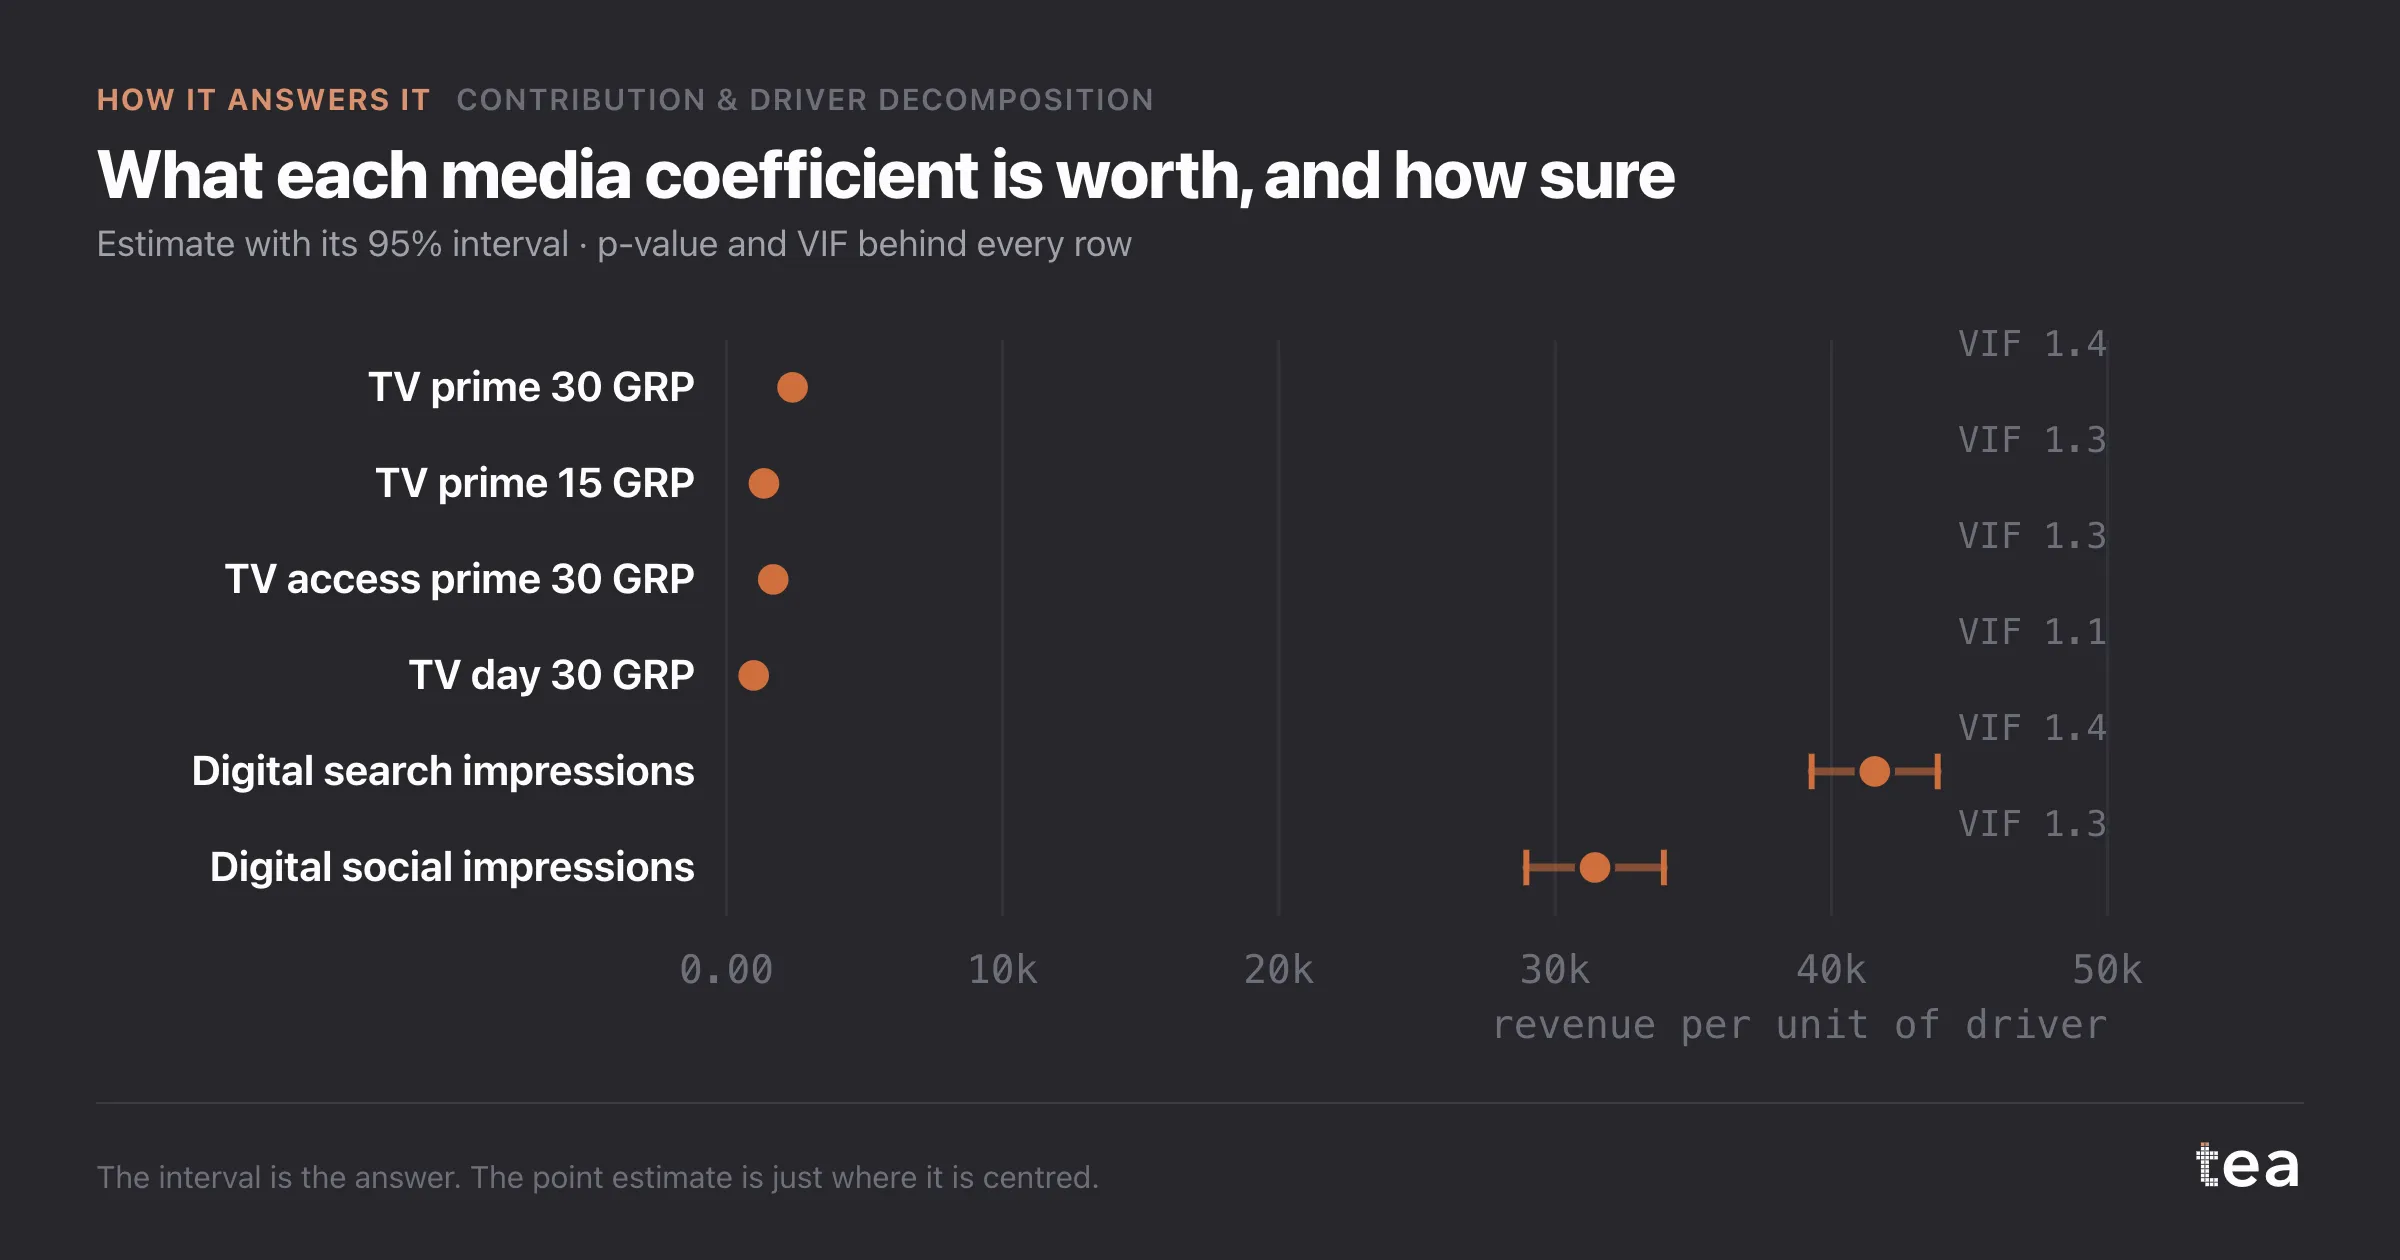
La diagnostica non è decorazione. Un Durbin-Watson di 1,93 dice che i residui non sono fortemente autocorrelati, che è la condizione perché gli intervalli su quei coefficienti significhino quello che dichiarano. Senza, ogni errore standard della pagina è ottimista.
E la colonna del VIF è dove i modelli media falliscono in silenzio. I canali pianificati negli stessi periodi producono coefficienti che si scambiano di posto. Il contributo totale può essere giusto mentre ogni singolo driver è inaffidabile, e solo la diagnostica di collinearità te lo dirà.
Il principio su cui costruiamo è semplice: tutto ciò che servirebbe a un revisore per non essere d’accordo con il risultato deve stare sulla stessa pagina del risultato.
Dodici modelli, i coefficienti, i residui, e quello che non faranno.
Una nota su dove questo morde di più. Chi possiede i dati è di solito la persona a cui viene chiesto di difendere il modello davanti a qualcun altro, e non è quasi mai chi l’ha costruito. Tutto quello che c’è su quella scheda di quattro righe esiste perché quella difesa sia possibile senza una telefonata.
La stessa scheda rende possibile anche il rifiuto, che conta ancora di più. Quando l’adattamento è scarso, o la collinearità è alta, o il periodo è troppo breve, un analista con la diagnostica davanti può dire «non su questi dati» con le prove in mano. Senza, le sole opzioni sono accettare il numero o diffidare dello strumento, e finiscono male tutte e due.
tea, il prodotto
Il tuo file, questa domanda
Quindici analisi su un CSV di dati settimanali, con intervalli e diagnostica in vista, e una frase chiara quando i dati non possono rispondere. Gratis durante la beta, su invito.
Chiedi un posto nella beta→tea, il prodotto
Quindici analisi econometriche sul tuo CSV: Scomposizione dei contributi e dei driver, curve di saturazione, elasticità, allocazione del budget. Intervalli e diagnostica in vista, e una frase chiara quando il file non può rispondere.
Gratis durante la beta, su invito.
Chiedi un posto nella beta →Ti è piaciuto? Eseguilo sui tuoi dati.
tea esegue Scomposizione dei contributi e dei driver e altre quattordici analisi su qualsiasi CSV settimanale, in pochi minuti. Gratis durante la beta, su invito.