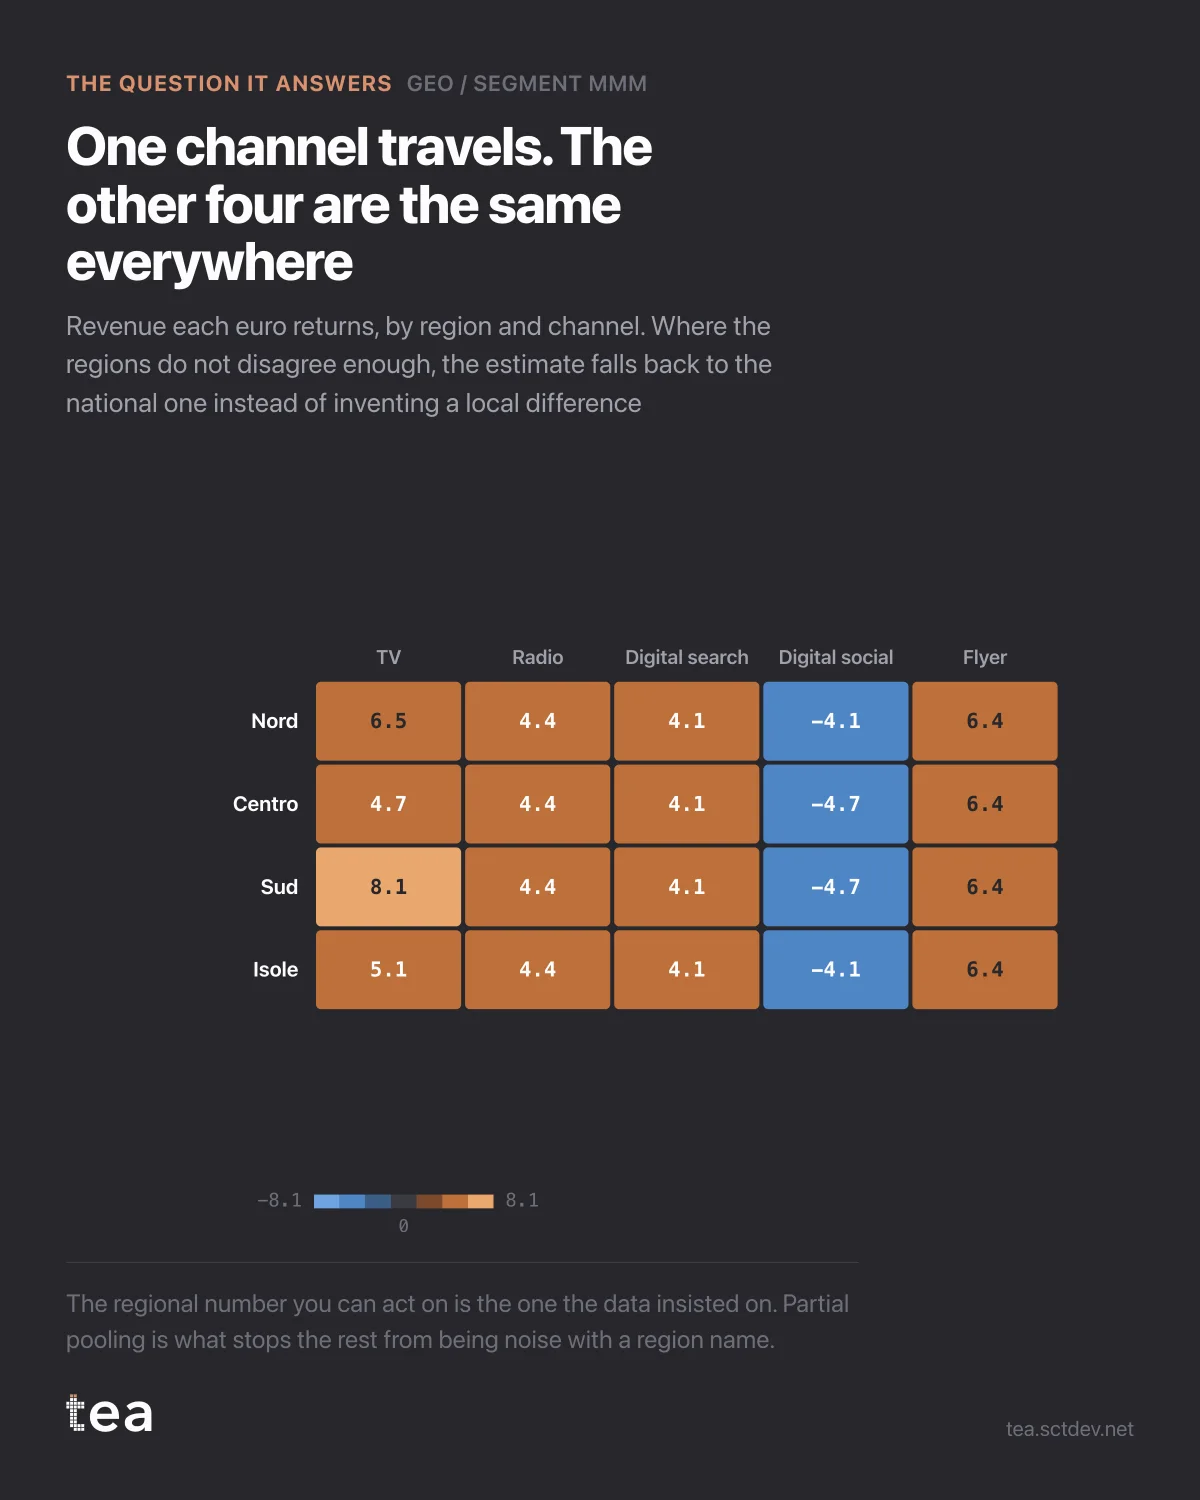
Quattro regioni, cinque canali, e la griglia mostra quanto rende ogni euro in ogni cella.
Scorri le righe e la maggior parte dei numeri si ripete. La radio rende 4,4 ovunque. Il search 4,1 ovunque. Il volantino 6,4 ovunque. Cambia solo la TV: 8,1 al Sud, 4,7 al Centro, con il Nord e le Isole in mezzo.
Non è il modello che fa il pigro. È il partial pooling che fa esattamente quello per cui esiste.
Ecco il problema che risolve. Stima ogni regione separatamente e ottieni quattro stime indipendenti, ognuna costruita su un quarto dei dati, ognuna con un intervallo largo e ognuna libera di andare dove la porta il suo rumore. Poi qualcuno costruisce un piano regionale su una differenza che non è mai esistita. Stimale invece tutte insieme e ottieni un solo numero nazionale che nasconde ogni differenza locale vera.
Il partial pooling sta in mezzo. La stima di ogni regione viene tirata verso la media nazionale, e quanto viene tirata dipende da quanta evidenza porta quella regione e da quanto le regioni sono davvero in disaccordo. Quando un canale si comporta davvero in modo diverso da regione a regione, le stime si separano. Quando la differenza apparente sta dentro quello che produrrebbe il rumore, ricadono sul numero nazionale.
Quindi questa griglia è una mappa di dove esiste un’evidenza locale. La TV ce l’ha. Gli altri quattro canali no, su questo file, con questa lunghezza di storico.
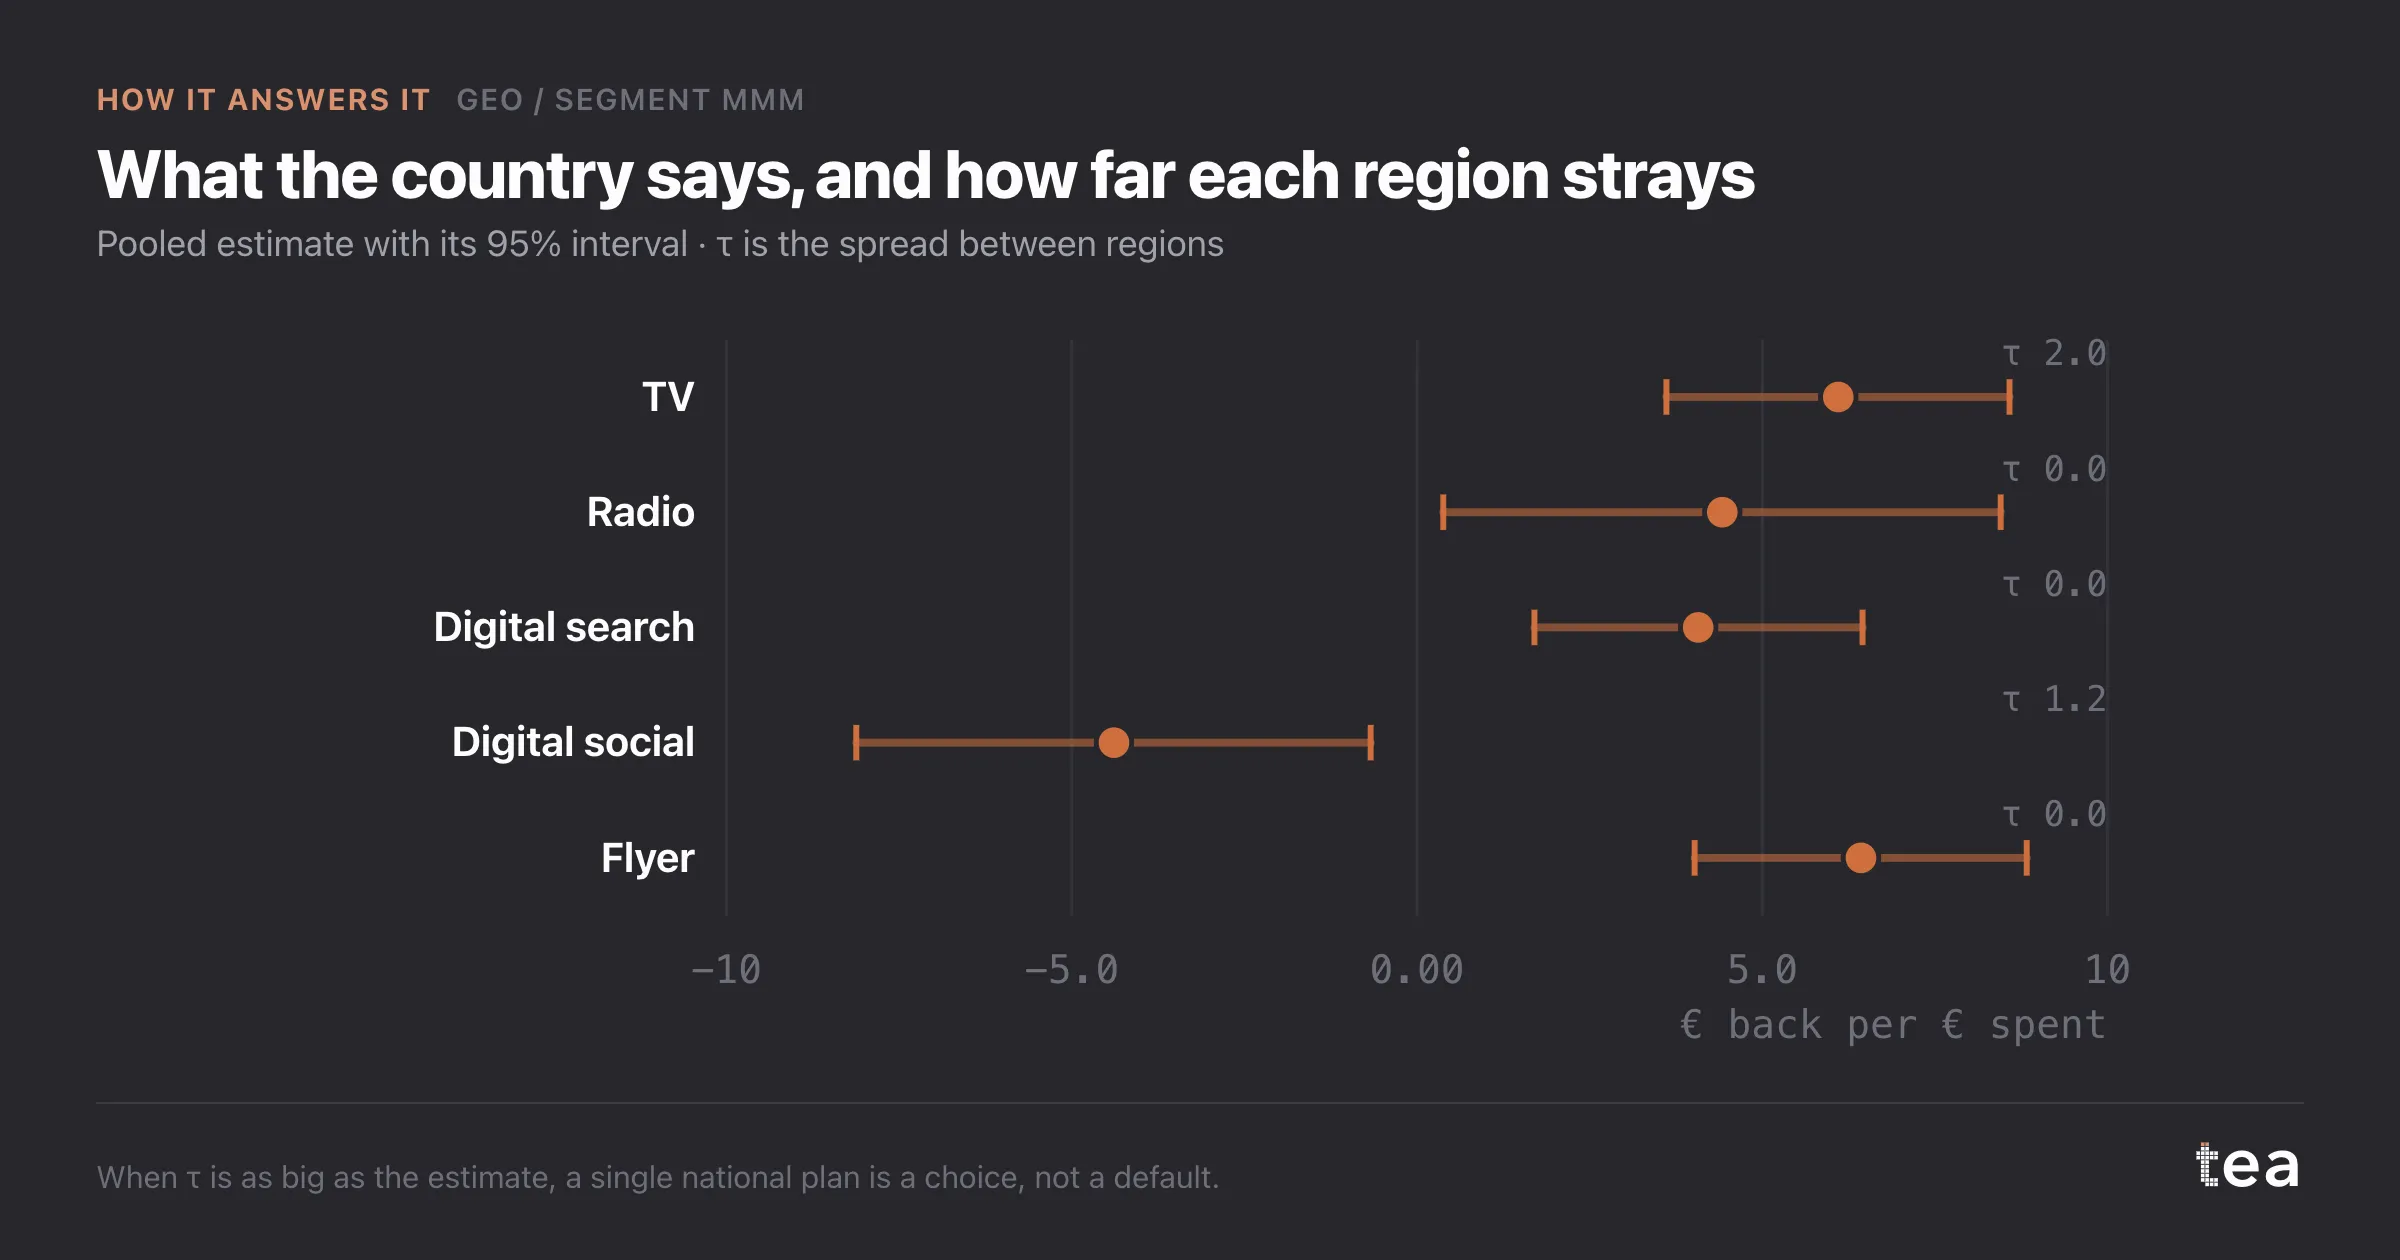
Per un piano la conseguenza è diretta. La TV la compri per regione, perché la differenza è reale e vale 3,4 punti di ritorno tra la regione migliore e la peggiore. Il resto lo compri a livello nazionale, perché le differenze regionali su cui pianificheresti non si distinguono dal rumore.
È un piano molto più corto e molto più sicuro di quello che avrebbero prodotto quattro regressioni separate.
Il requisito pratico è una colonna. Lo stesso file settimanale che useresti per un modello nazionale, con in più una colonna di regione, città, gruppo di punti vendita o segmento, e abbastanza periodi per segmento perché ognuno abbia qualcosa da dire. Quattro regioni su 104 settimane fanno 416 righe, che è comodo.
Quello che restituisce è una decisione che la maggior parte dei team prende ogni anno a istinto: quanto deve essere locale il piano. L’istinto di solito risponde con l’organigramma, perché esiste un team regionale, o con la richiesta più rumorosa. La varianza nei dati risponde in un altro modo, e costa meno.
E quando la griglia torna completamente uniforme, è un risultato anche quello. Vuol dire che il piano nazionale è il piano giusto, e puoi smettere di spendere tempo del management su eccezioni regionali che il mercato non sostiene.
Il grafico è l’output reale di MMM geo / per segmento in TEA, eseguita su un file di esempio che chiunque può scaricare.
tea, il prodotto
Il tuo file, questa domanda
Quindici analisi su un CSV di dati settimanali, con intervalli e diagnostica in vista, e una frase chiara quando i dati non possono rispondere. Gratis durante la beta, su invito.
Chiedi un posto nella beta→tea, il prodotto
Quindici analisi econometriche sul tuo CSV: MMM geo / per segmento, curve di saturazione, elasticità, allocazione del budget. Intervalli e diagnostica in vista, e una frase chiara quando il file non può rispondere.
Gratis durante la beta, su invito.
Chiedi un posto nella beta →Ti è piaciuto? Eseguilo sui tuoi dati.
tea esegue MMM geo / per segmento e altre quattordici analisi su qualsiasi CSV settimanale, in pochi minuti. Gratis durante la beta, su invito.